脳とAI研究の間には、何十年も解けないままの食い違いがある。現在のAIの強さを支えるのは「バックプロパゲーション(誤差逆伝播法)」というアルゴリズムで、誤差の情報を出力側から入力側へ、層をまたいで正確に伝え返すことで学習を進める。ところがこれに対応する仕組みは、脳の中にはっきりとは見つかっていない。一方で、学習済みの人工ニューラルネットワークの内部活動と、生物の視覚系の活動パターンを比べると、興味深い類似が繰り返し報告されてきた。脳がバックプロパゲーションをそのまま行っているとは考えにくいのに、なぜ結果だけはそれによく似てくるのか――この問いに、マサチューセッツ工科大学(MIT)マクガバン脳研究所の新しい研究が、一つの答え方を示した。ランダムに結合しただけの「ニューロンもどき」の集まりに、生物学的にもっともらしい局所的な可塑性ルールだけを与えておくと、誰にも教わらずに、バックプロパゲーションに近い性能で学習できる回路へと自ら組み上がっていくというのだ。研究は2026年10月9日、米科学アカデミー紀要(PNAS)に掲載された。
原題(Title): How Biological Synapses Self-Assemble Gradient Learning
著者(Authors): Qianli Liao, Liu Ziyin, Yulu Gan ほか
掲載誌(Journal): Proceedings of the National Academy of Sciences(PNAS)
DOI: 10.1073/pnas.2606245123
脳とAI、40年来のズレ
現在の深層学習はほぼすべて、バックプロパゲーションという学習法の成功の上に成り立っている。ネットワークが予測を出し、正解との誤差を出力側から入力側へ層ごとに送り返しながら、誤りを減らす方向へ結合の重みを調整していく。この方法は驚くほどうまく機能するが、標準的な実装では、順方向と逆方向の結合のあいだに厳密な数学的対応関係が必要で、誤差の情報をネットワーク全体へ協調して伝える仕組みも要る。大脳皮質の回路がこれに相当する仕組みを備えているという確立された証拠は、今のところ見つかっていない。
研究が進むにつれ、この謎はむしろ深まった。バックプロパゲーションで訓練したネットワークの内部活動と、生物の視覚系で記録された活動パターンを比べる研究では、偶然とは言えない類似が繰り返し報告されてきたからだ。脳がバックプロパゲーションを実行している証拠にはならないが、素朴な疑問が残る。脳が本当にそれをしていないなら、どんな局所的な仕組みがこれほど似た計算を生み出しているのか。
ランダムな結合に、局所ルールだけ
MITのチームは、Qianli Liao氏、Liu Ziyin氏、Yulu Gan氏が中心となり、Mark Harnett氏とTomaso Poggio氏がシニア著者として、Brian Cheung氏も加わって研究を進めた。バックプロパゲーションを「もっと生物学的にする」という従来の試みとは違い、あらかじめ回路を設計するのではなく、ほぼ何もない状態から出発した。多層に並んだ「ニューロンもどき」のユニットを、決まった配線図なしにランダムに結合させただけなのだ。
このシステムが従うのは、シナプスの局所的な可塑性ルールで、一つのシナプスだけでなく周辺の活動に応じて結合が変化する「ヘテロシナプス可塑性」という仕組みも含まれる。これは「同時に発火した細胞同士の結合が強まる」というおなじみのヘブ則の、より具体的な親戚にあたる。重要なのは、これらのルールが必要とする情報が、それぞれのシナプス(神経細胞どうしの接合部)の近くだけで得られる、ローカルな情報に限られている点だ。どのユニットもネットワーク全体の状況を知る必要はなく、システム全体に向けた単一の誤差信号が放送されることもない。
自ら組み上がる「回路」
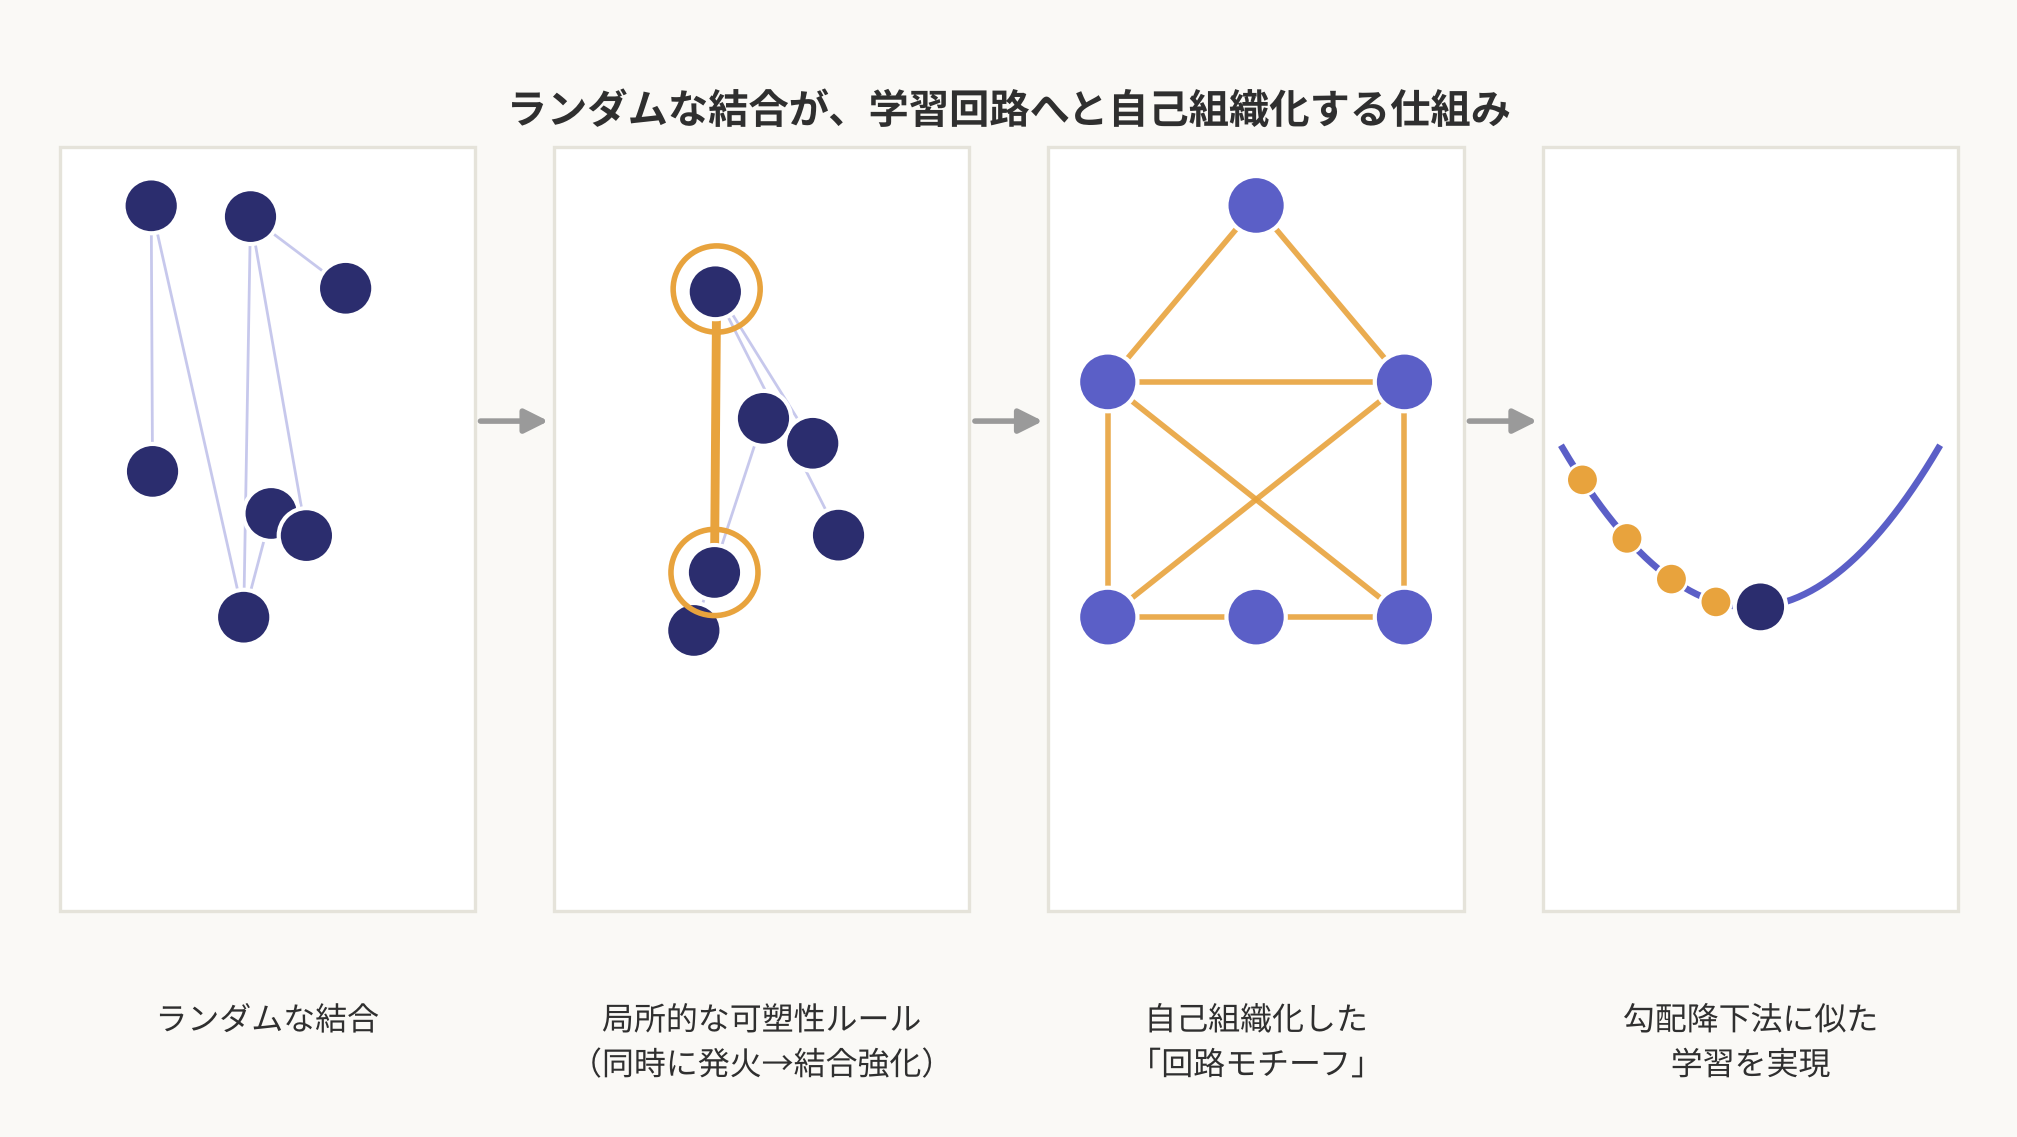
局所ルールのもとで動かし続けると、ランダムに結合していたユニットは、ランダムなままではいられなくなる。活動が繰り返されるうちに、ネットワークの中に、研究チームが「自己組織化モチーフ」と呼ぶ、小さく繰り返し現れる配線パターンが育っていった。モデルの解析によれば、脳の「上行性(ボトムアップ)」経路と「下行性(トップダウン)」経路を結ぶ、4つのシナプスからなる特定のモチーフが浮かび上がるという。これは実際の脳組織ですでに確認されたパターンではなく、実験神経科学者がこれから探しにいける、具体的な構造上の予測だと位置づけられている。
さらに興味深いのは、このモチーフたちがその後に何をするかだ。モチーフ同士がネットワークとしてさらに自己組織化し、その全体の振る舞いが、確率的勾配降下法――バックプロパゲーションを含む最適化手法の一群――を一般化したようなダイナミクスに近づいていく。しかもそれは、誰かが設計した統括アルゴリズムによってではなく、局所的な結合ルールの積み重ねだけで実現される。言い換えれば、このネットワークは訓練データから何かを学ぶ前に、まず自分自身が学ぶための「装置」を組み立てる必要があったのだ。
ランダムな結合から出発しても、局所的なシナプス可塑性ルールだけで、組み合わさると勾配降下法に似た学習を実現する回路モチーフを組み立てるには十分だった。
AIの学習法に匹敵する成績
生物学的にもっともらしい回路というだけでは、実際に機能しなければ意味がない。そこで研究チームは、この自己組織化したネットワークに画像のパターン認識・分類のタスクを解かせた。MITの発表によれば、自己組織化した回路は、同じタスクでバックプロパゲーションを直接使った従来型ネットワークに匹敵する性能を示したという。ただし発表文には具体的な正答率やベンチマークの詳細はなく、それらを知るにはPNAS論文本体にあたる必要がある。この結果は「今回試したタスクでは自己組織化が目立った代償を伴わなかった」という証拠であり、深層学習全般でバックプロパゲーションに匹敵するという一般論として読むべきではない。
それでも意味は大きい。生物学に着想を得たバックプロパゲーションの代替案は、これまで実際のタスクでは性能面で及ばないことが多かったからだ。ランダムな配線から自己組織化しながら、少なくとも今回のタスクで渡り合える回路の存在は、その差を一例に限ってではあるが縮めて見せた。
脳で検証できる具体的な予測
研究チームは、このネットワークが学習できるからといって、人間の脳が実際にこの方法で学習していると証明されたわけではない、と慎重に断っている。あくまで候補となる仕組みの一つであり、確定した答えではない。ただし計算論的神経科学の理論提案の多くとは違い、今回の研究には具体的で反証可能な予測が伴う。もし脳が本当にこれに近いことをしているなら、大脳皮質の回路には、上行性と下行性の経路を結ぶ、あの4シナプスのモチーフが存在するはずだ、というものだ。実験神経科学者は今、まさにそのような配線の痕跡を、実際の脳組織の中に探しにいくことができる。エレガントなシミュレーションを、検証可能な科学的仮説へと変える一歩だと言える。
研究室の外への広がり
予測が裏づけられれば、恩恵は両方向に広がりうる。神経科学にとっては、学習回路の存在が確認されれば、脳が生涯を通じてどう適応するかの手がかりとなり、学習や記憶に関わる不調の理解や、将来の脳とコンピュータをつなぐインターフェース設計にも生かせるかもしれない。ただしこれらはまだ実証された成果ではなく、今後の可能性にとどまる。
AI研究にとっての教訓は、むしろ逆向きだ。現在のネットワークは、どの結合をどう学習させるかをエンジニアがあらかじめ設計する、トップダウンの発想でつくられている。ランダムな配線と局所的な可塑性ルールだけから学習機構を組み立てられるシステムは、データに触れながら自らを構成していく、別のアーキテクチャの可能性を示す。Liao氏らも、結果はその方向への最初の一歩に過ぎないと位置づけつつ、すでに組み上がったネットワークがどう学ぶかだけでなく、学習そのものをどう「あらかじめ組み込んでおける」かという新しい問いを残した。
人工知能と生物の知能がどこで今もすれ違っているのかについては、人は何かを選んだ後、脳の中の「情報の並べ方」を組み替えていた――MITの発見、柔軟に学習するAI設計の参考にで紹介した、MITの別の研究も参考になる。意思決定の瞬間に脳が情報を並べ替えるという発見で、AI研究者が柔軟な学習のあり方を考え直すきっかけになっている。
Xsciens編集部の読み解き
脳とAIの学習の食い違いに対して、「回路を設計せず、ランダムな結合から自己組織化させる」という別の答え方を示したのが、この研究の特徴です。
- シミュレーション上の結果であって、脳での確認ではない。ランダムに結合したユニットが局所ルールだけで学習回路を組み上げるのは、モデルの中での話です。人間の脳が実際にこの方法で学習しているとは、記事にあるとおり証明されていません。
- 「匹敵する性能」は限られた条件の話。画像のパターン認識・分類のタスクで、バックプロパゲーションを直接使った従来型ネットワークに匹敵したとされますが、具体的な正答率はMITの発表文に示されていません。深層学習全般に当てはまる一般論としては読めません。
- この研究の価値は、検証できる予測を出したこと。上行性と下行性の経路を結ぶ4シナプスのモチーフが実際の大脳皮質にあるかは、実験で調べられます。見つかれば仮説の支持に、見つからなければ修正の材料になります。
この読み解きの参考: MIT News の解説、原論文(PNAS)
出典: MIT News、Proceedings of the National Academy of Sciences(PNAS)、arXivプレプリント
あわせて読みたい: AIの学習の仕組みを基礎から知りたい方はバックプロパゲーションとは?3分でわかる仕組みと将来性をどうぞ。
コメントを残す