タグ: 人工知能

  • 【科学】バックプロパゲーションとは?3分でわかる仕組みと将来性

    【科学】バックプロパゲーションとは?3分でわかる仕組みと将来性

    バックプロパゲーション(Backpropagation、誤差逆伝播法)は、人工知能の「ニューラルネットワーク」が自分の間違いから学習するための計算手法です。今の生成AIチャットボットから、スマホの顔認証まで、私たちが「AI」と呼ぶものの多くは、この仕組みの上に成り立っています。基本だけでも理解しておくと、最新のAIが実際には何をしているのかがぐっと見えやすくなります。

    元論文情報

    タイトル: Learning representations by back-propagating errors
    著者: David E. Rumelhart, Geoffrey E. Hinton, Ronald J. Williams
    掲載誌: Nature, Vol. 323, pp. 533–536(1986年)
    DOI: 10.1038/323533a0

    バックプロパゲーションとは

    ひとことで言えば、バックプロパゲーション(誤差逆伝播法)は、ニューラルネットワークの答えがどれくらい間違っていたかを繰り返し計算し、どの向きに修正すればよいかを求める手法です。ニューラルネットワークは、ニューロンに緩くヒントを得た処理単位を何層にも重ね、「重み」と呼ばれる調整可能なつながりの強さでつないだ構造をしています。作られたばかりのネットワークの重みは小さなランダムな値から始まるため、最初の予測はたいてい的外れです。バックプロパゲーションは、その出発点を、写真の中の猫を見分けたり、文章を翻訳したりできるネットワークへと鍛え上げていく手続きです。

    押さえておきたい区別が一つあります。バックプロパゲーションは「各つながりが誤差にどれだけ影響したか」を計算するだけで、その情報をもとに重みを実際に調整するのは、勾配降下法(Gradient Descent)と呼ばれる別のステップです。日常的には「バックプロパゲーション」が学習プロセス全体を指す言葉として使われがちですが、厳密にはこの二つは連携して働く別々の工程です。

    仕組み:順伝播と逆伝播

    バックプロパゲーションによる学習は、二つの「パス(経路)」で進みます。まず順伝播(フォワードパス)では、写真や文章、センサーの数値列といった入力が、ネットワークの層を順番に通り抜けて予測を生み出します。その予測は、損失関数(Loss Function)と呼ばれる指標を使って正解と比較され、予測が正解からどれだけ離れていたかが数値として表されます。

    バックプロパゲーションは、ネットワークに「何を考えるべきか」を教えるのではありません。「どれだけ間違っていたか」と「次に少しでもましになるには、各つながりをどちらに動かせばよいか」を教えているのです。

    数式の前に、簡単なたとえを挟みます。工場の生産ラインで完成品に不良が見つかったら、担当者はラインの終わりから逆向きにたどり、各工程が問題にどれだけ関わっていたかを報告し、その情報を一つ前の工程へ渡していきます。逆伝播(バックワードパス)がやっていることも、これとよく似ています。ただし数学の力で正確に行う点が違います。出力層から入力層に向かって、連鎖律(チェーンルール)と呼ばれる微積分の技法を層ごとに適用し、各層は自分の計算が次の層に与えた影響と、戻ってきた誤差の情報を組み合わせて勾配(グラディエント)を作り出します。勾配とは、ある重みを少しだけ動かしたとき、損失がどれくらい敏感に変化するかを示す指標です。
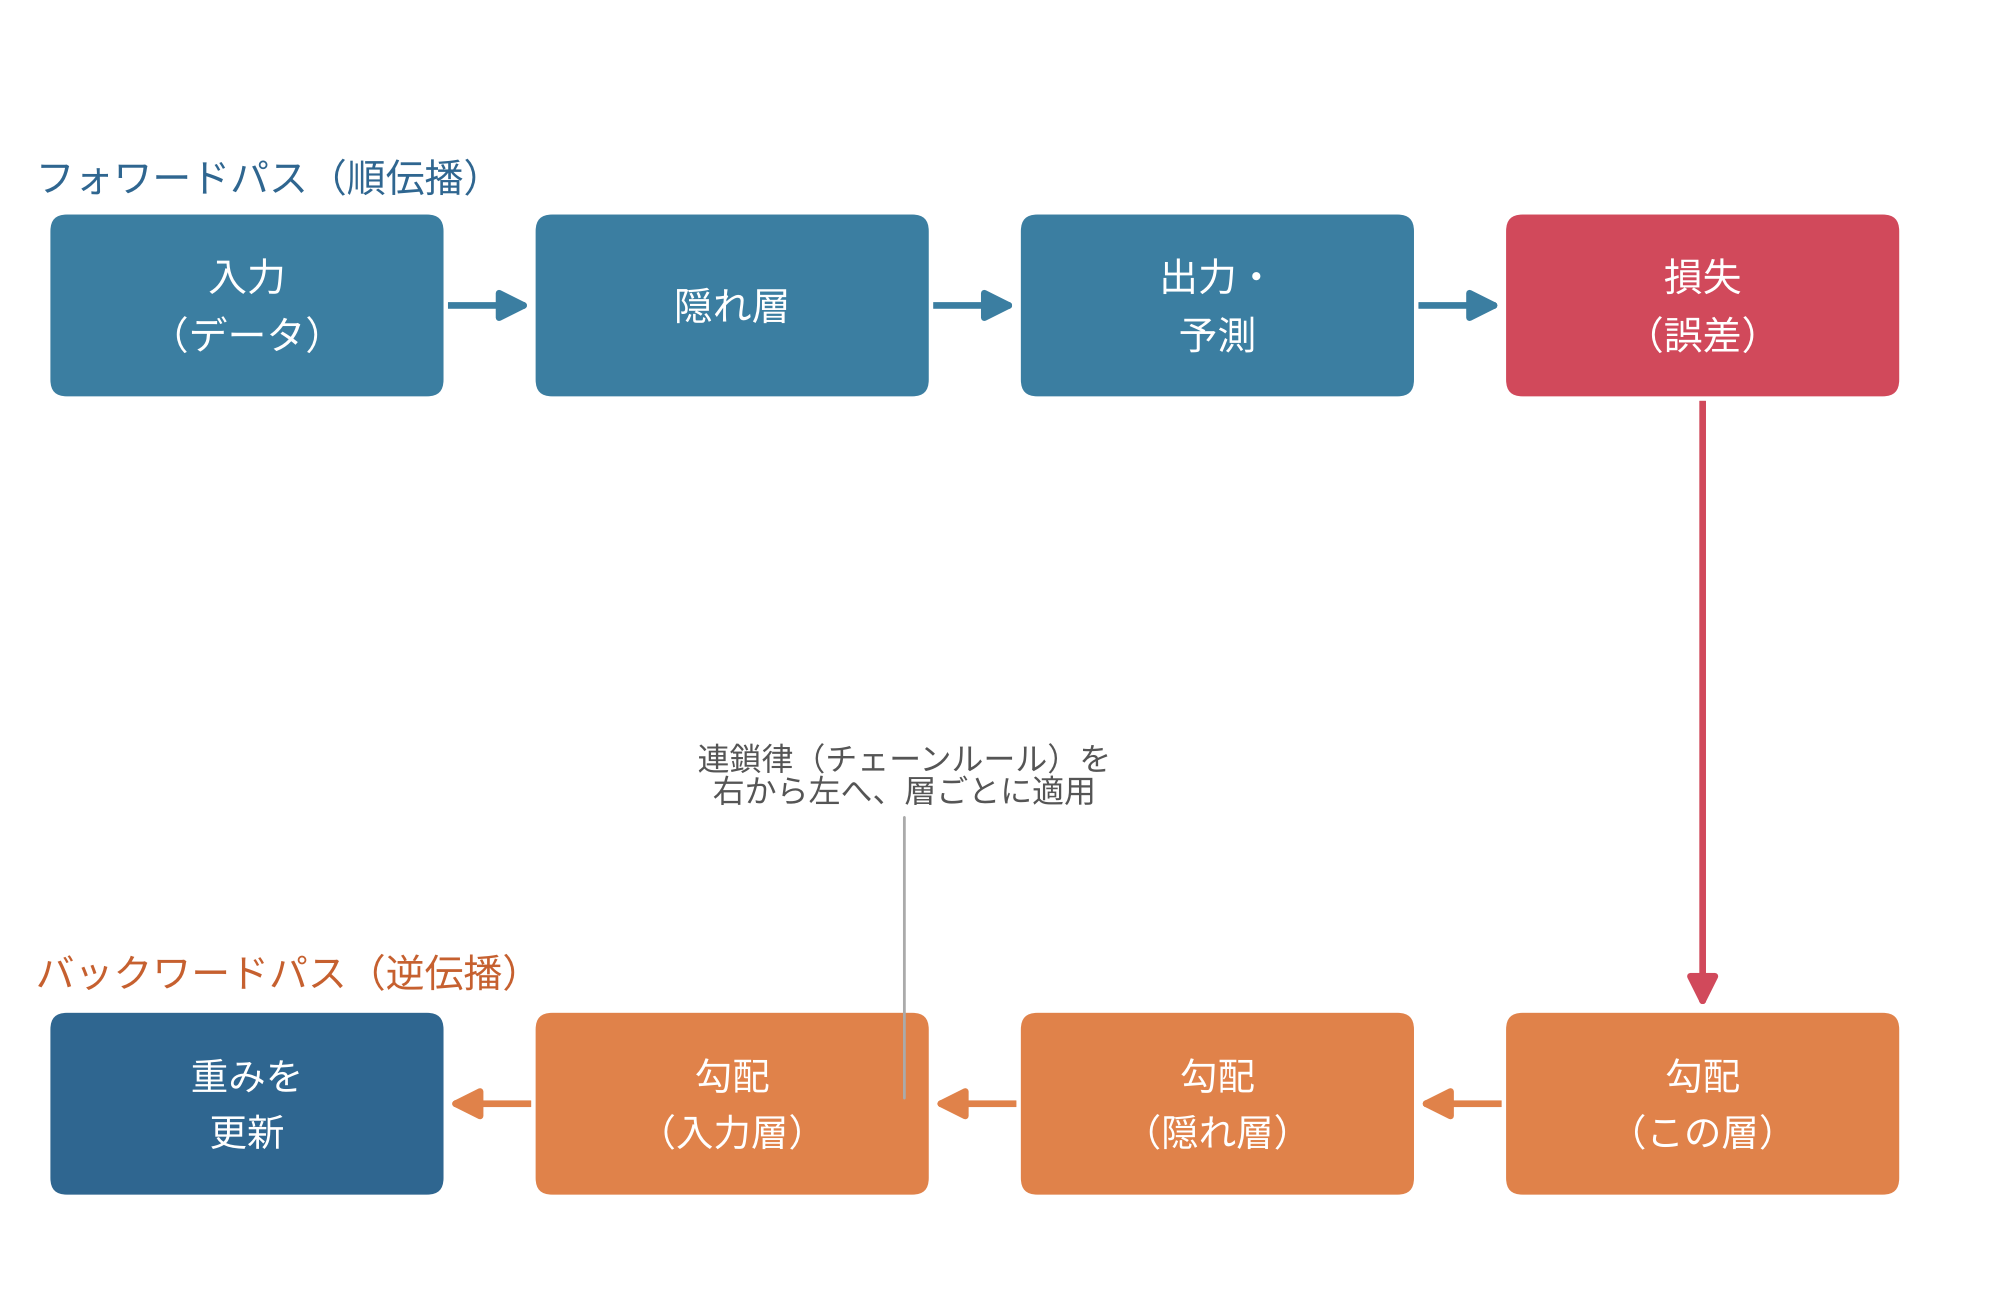
    バックプロパゲーションにおける順伝播と逆伝播の流れを示す図
    順伝播で予測と損失が計算され、逆伝播では連鎖律を使って層ごとに勾配を求め、重みを更新する。

    すべての重みの勾配が求まったら、勾配降下法がそれを使って重みを実際に更新し、誤差が小さくなる方向へ動かします。この「順伝播→逆伝播→更新」のサイクルを数百万回と繰り返すことで、ランダムな重みから出発したネットワークが、データの中の本物の構造を少しずつ反映するようになります。バックプロパゲーションの魅力は効率の良さです。重みを一つずつ個別に実験して確かめるのではなく、ごく少数の順伝播・逆伝播を行うだけの時間で、全ての重みの勾配をまとめて計算できます。

    歴史となぜ今注目されるか

    バックプロパゲーションは新しい技術ではなく、有名になるずっと前から数学的な土台は探求されていました。核となる「自動微分の逆モード」は、フィンランドのセッポ・リンナインマー(Seppo Linnainmaa)が1970年の修士論文で考案したものにさかのぼります。アメリカのポール・ワーボス(Paul Werbos)も1974年の博士論文で、近い発想をニューラルネットワークへ応用することを提案しました。広く知られるようになったのは、ラメルハート・ヒントン・ウィリアムズの3名が1986年にNature誌へ発表した論文がきっかけです。この論文は、人間が逐一設計しなくても、ネットワークがデータから有用な内部表現を自動で見つけ出せることを示しました。

    その後しばらく、バックプロパゲーションで学習するネットワークは、データと計算力の制約から研究上の対象にとどまっていました。状況が変わったのは2012年です。アレックス・クリジェフスキー(Alex Krizhevsky)らが、指導教員のジェフリー・ヒントンとともに、バックプロパゲーションと大規模画像データセット「ImageNet」、GPUの計算力を組み合わせた「AlexNet」を発表しました。AlexNetはその年のImageNet画像認識コンペティションで他を大きく引き離し、現在のディープラーニング・ブームの引き金になったと広く評価されています。今日の生成AIチャットボットを支える大規模言語モデルも、根本では同じアルゴリズムの発展形で学習しています。
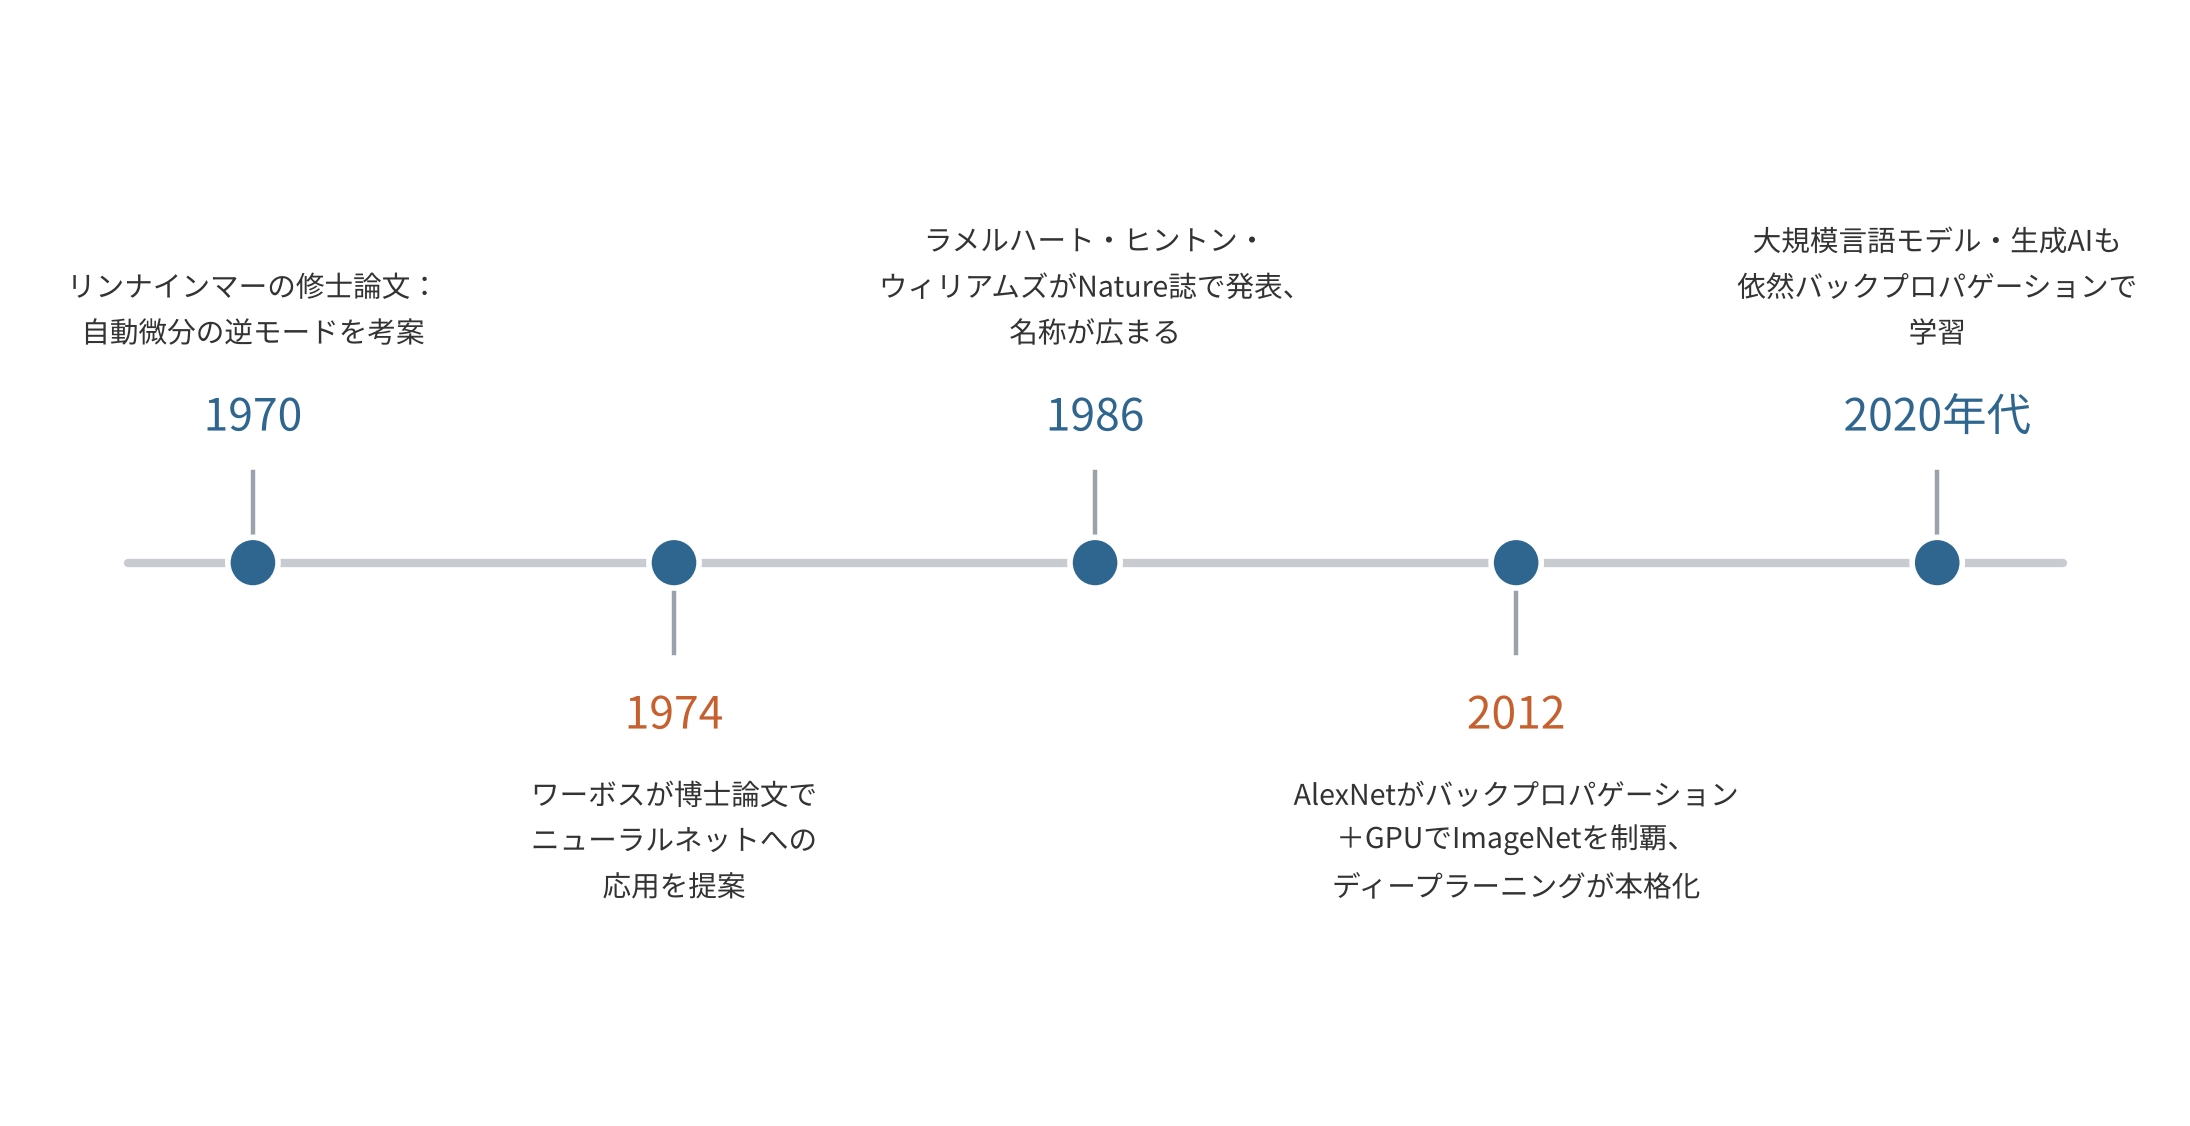
    バックプロパゲーションの歴史を示す年表(1970年から2020年代まで)
    出典: リンナインマー(1970年)、ワーボス(1974年)、ラメルハート・ヒントン・ウィリアムズのNature論文(1986年)、AlexNet/ImageNetの成果(2012年)をもとに作成。

    最近バックプロパゲーションが改めて注目を集めているのは、「脳もこれと似たことをしているのだろうか」という、少し違う角度の問いからです。2026年10月、MITマギガバン脳研究所のチームが米国科学アカデミー紀要(PNAS)に発表した研究は、あるコンピュータモデルを提案しました。ランダムに接続された人工ネットワークが、生物のシナプスにヒントを得た「局所的な学習ルール」だけを使い、大域的な誤差信号なしに順伝播とフィードバック経路の両方を自分自身で組み立て、試されたタスクではバックプロパゲーションに迫る学習能力を示した、というものです。研究チームはこれを「検証可能な仮説」と位置づけ、実際の脳がこの通りに動くと証明したわけではないと慎重に断っています。それでも、神経科学者を40年近く悩ませてきた問いが改めて浮かび上がります。バックプロパゲーションは今日のAIを動かす力を持ちますが、生物の脳が同じことをしている証拠はまだないのです。(関連記事: 脳は自ら学習回路を組み立てる?――MIT、AIと脳をつなぐ40年来の謎に新仮説)

    暮らしの中のバックプロパゲーション

    数式自体は裏側に隠れていますが、バックプロパゲーションで学習したネットワークの成果は、すでに日常生活のあちこちに入り込んでいます。スマートフォンの顔認証機能や、写真を自動でグループ分けするアルバムアプリの多くは、バックプロパゲーションや関連する勾配ベースの手法で学習したネットワークの上に成り立っています。音声アシスタントも、おおむね同じように学習したネットワークに支えられています。生成AIチャットボットも同様で、「事前学習」の段階では言語モデルが次の単語を予測し、実際の単語と見比べて誤差を測り、それを減らす方向へ重みを調整する作業を繰り返します。その後の段階で、指示への従い方やフィードバックへの応答がさらに磨き上げられます。

    覚えておきたい区別があります。バックプロパゲーションが働くのは主に学習のときで、私たちがツールを使うたびに毎回働くわけではありません。学習を終えたネットワークは、通常すでに調整済みの重みを使って予測するだけで、勾配の計算や更新はそのつど行いません。大変な作業は、しばしば数十億件もの訓練例を使って、あらかじめ済ませてあるのです。

    次に注目すべきこと

    バックプロパゲーションそのものは、すでに成熟し、よく理解された技術です。だからこそ、残された問いはその限界と代替手段のほうに移っています。一つは科学的な問いです。MITが示した自己組織化する学習回路や、フィードバックアラインメント、予測符号化と呼ばれる関連手法が、実際の神経組織での検証に耐え、より大規模な課題でもバックプロパゲーションに匹敵する性能を出せるのか、という点です。もう一つは実用上の問いです。AIモデルが巨大化し続けるなか、研究者たちは精度を保ちながら計算資源を減らす学習方法を探しています。次のブレークスルーは、バックプロパゲーション自体を速くすることではなく、ネットワークがそれに頼らず学習する方法から生まれるのかもしれません。

    Xsciens編集部の読み解き

    バックプロパゲーションは、ネットワークが自分をどう調整すべきかを正確に計算するための「帳簿づけの技術」と捉えるのが一番しっくりきます。人工であれ生物であれ、脳が実際に「どう考えているか」の理論ではありません。

    • よくある誤解。「ニューラルネットワーク」という名前のせいで、脳の学習をそのまま真似ていると思われがちですが、人工的な「ニューロン」はあくまで生物のニューロンに緩くヒントを得ただけの存在です。標準的なバックプロパゲーションの逆伝播計算は、順伝播で使ったつながりに対応する重みの情報を正確に使う必要がありますが、実際のニューロンがこれと同じ仕組みを再現している証拠はありません(フィードバックアラインメントのような、この要件を緩めた代替手法が研究されていること自体が、この問題がいかに特定の条件を要求しているかを物語っています)。人工ニューロンと生物のニューロンの「似ている感じ」は、あくまで緩やかなたとえ話であり、どちらも実際に何を計算しているかを正確に説明するものではありません。
    • 限界と未解決の問い。バックプロパゲーションは必ず人間が与えた「正解」が必要だ、という誤解がよくありますが、これは正確ではありません。必要なのは微分可能な学習目標であり、それは人がラベル付けした正解から得られることもあれば、文章の次の単語を予測するような自己教師あり学習の課題や、強化学習的な報酬から得られることもあります。バックプロパゲーション自体が説明しないのは、なぜあるネットワーク構造は未知のデータにもうまく対応でき、別の構造はそうならないのか、あるいはAIシステムが何を学ぶべきかをそもそもどう決めるのか、といった点です。これらは決着のついていない、今なお活発に研究されている問いのままです。
    • 次に注目すべきこと。MITチームによる2026年10月の研究は、大脳皮質の上行経路と下行経路をつなぐ「4つのシナプスから成る配線パターン」があれば、実際の神経回路も同じような学習能力を自己組織化できるかもしれない、という検証可能な仮説を具体的に提示しています。これはモデルが示した予測であって、脳組織で確認された事実ではありません。神経科学者たちが実際にこの配線パターンを見つけられるかどうか、そして局所的なルールに基づく学習が、これまでより大幅に大きな問題でもバックプロパゲーションに匹敵する性能を出せるかどうかが、注目すべき二つのポイントです。
    • 編集部から――脳の仕組みにヒントを得た、この「局所学習」の研究がこのチームの期待通りに育てば、私たちが日々使うAIアシスタントは、使うたびに一から説明し直す無機質な道具ではなく、一人ひとりの使い方に静かに寄り添っていく存在に変わっていくかもしれません。そこへ至る道筋として考えられるのは、研究室を出たあとも学習を続け、普段使いの中の経験から少しずつ賢くなっていくようなシステムでしょう。ただし、自分で学び続けられるというその能力こそが、注意して見ておくべき点でもあります。何を静かに学び取っているのかを確かめる手立てがなければ、妙な情報や誤った経験から、見当違いのくせを身につけてしまうこともあり得るからです。これはまだ初期のコンピュータ上の実証実験であり、完成した製品ではありません。もしAIアシスタントが「前より自分のことを分かってくれている」と感じる場面が増えてきたら、ときどき「それは、どんな経験から学んだ結果なのだろう」と考えてみる価値はありそうです。

    この読み解きの参考: Quanta Magazine — Artificial Neural Nets Finally Yield Clues to How Brains Learn、arXiv — Brain-Inspired Machine Intelligence: A Survey of Neurobiologically-Plausible Credit Assignment

    出典: IBM — What Is Backpropagation?、TechTarget — What Is a Backpropagation Algorithm?、Rumelhart, Hinton & Williams, Nature (1986)、Seppo Linnainmaa、Computer History Museum — AlexNet Source Code、Xsciens — 脳は自ら学習回路を組み立てる?――MIT、AIと脳をつなぐ40年来の謎に新仮説

    関連記事:脳は自ら学習回路を組み立てる?――MIT、AIと脳をつなぐ40年来の謎に新仮説 / 人は何かを選んだ後、脳の中の「情報の並べ方」を組み替えていた / 認知オフローディングとは?3分でわかる仕組みと注意点
  • 【経済】AIを「使いこなせている」は3割弱――仕事を奪われる不安、40代以上にも広がる

    【経済】AIを「使いこなせている」は3割弱――仕事を奪われる不安、40代以上にも広がる

    生成AIがこれだけ話題になっても、「自分はAIをうまく使いこなせている」と胸を張れる人は、まだ全体の3割に満たないらしい。電通総研が2026年10月19日に発表した年次調査「クオリティ・オブ・ソサエティ指標2026」によると、AIの活用度には大きな世代差がある一方で、「AIに仕事を奪われるかもしれない」という不安は、前年の2025年調査と比べて若年層だけでなく40代以上にも広がり、年代による差が縮まったことが分かった。働く人の暮らしや将来設計に関わる話として、ポイントを整理する。

    原論文情報 / Original Paper
    発表タイトル(Title): “Quality of Society Index 2026”(クオリティ・オブ・ソサエティ指標2026)
    発表機関(Authors): 株式会社電通総研 ヒューマノロジー創発本部 Quality of Societyセンター
    発表元(Journal): 電通総研 プレスリリース
    DOI: https://www.dentsusoken.com/news/release/2026/1019.html

    この調査は、電通総研のシンクタンク組織であるQuality of Societyセンターが2019年から毎年実施しているもので、2026年6月23日から30日にかけて、18〜79歳の男女12,000人を対象にインターネット調査として行われた(調査機関は電通マクロミルインサイト、標本誤差は信頼区間95%・回答割合50%の場合で最大±1.3ポイント)。人々の意識の変化を長期的に追いかけている定点調査であり、今回初めてAIの活用度やAIエージェントへの受容度についての質問が加えられた。

    「使いこなせている」はまだ3割弱

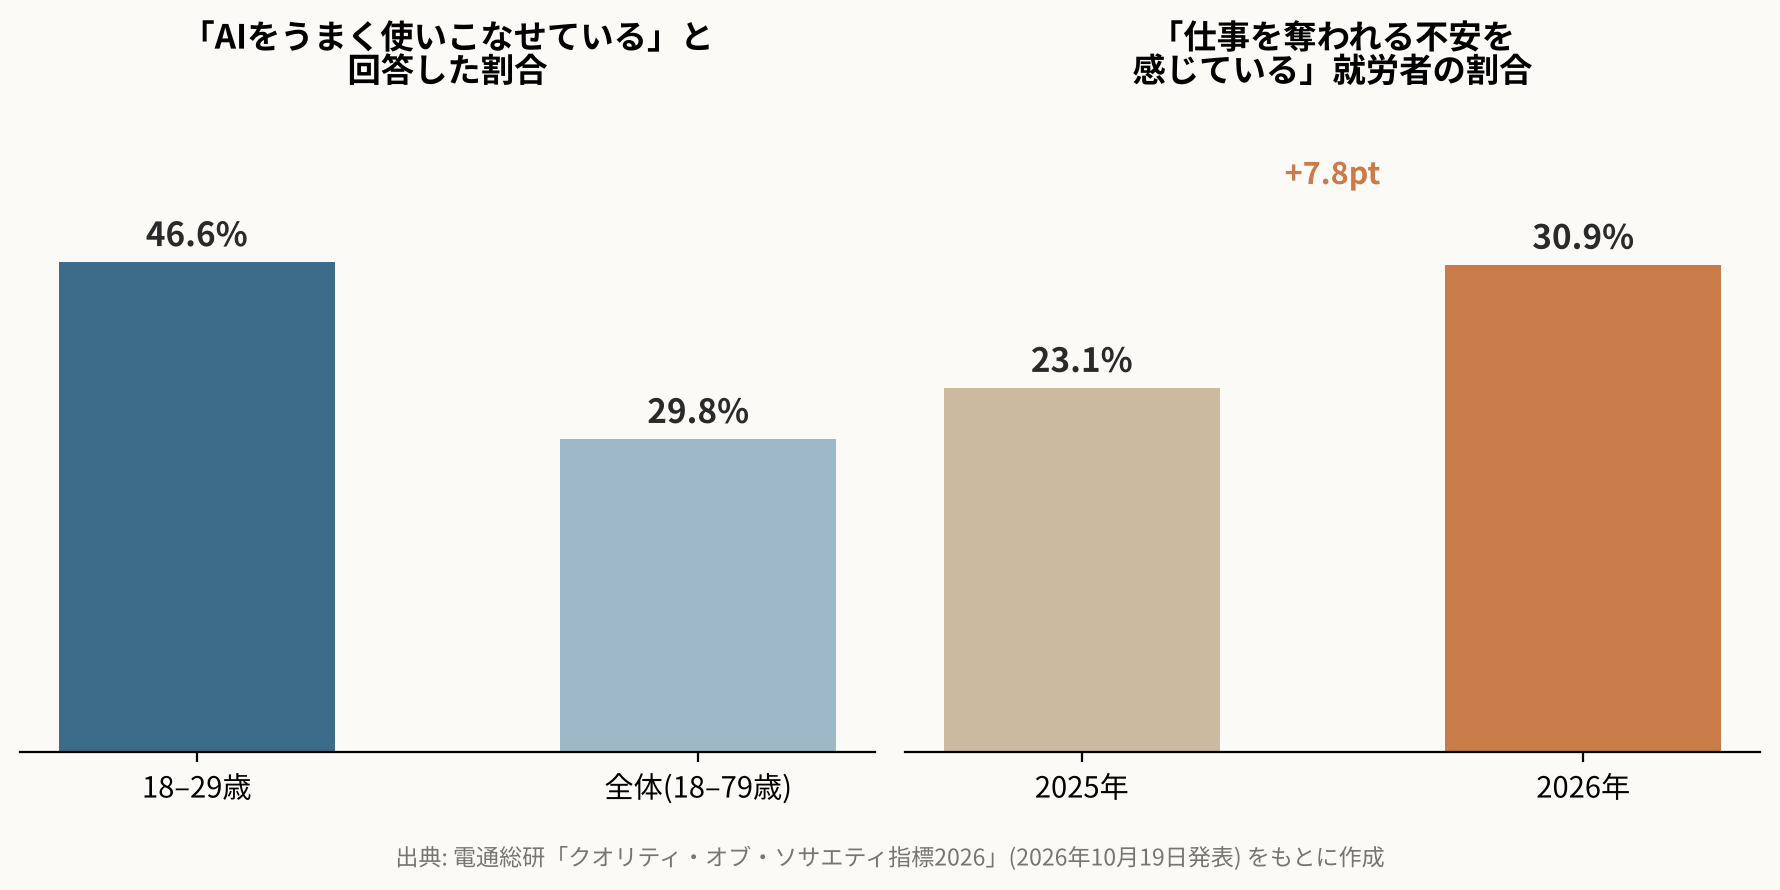
    「自分は、AI(人工知能)をうまく使いこなせていると思う」という問いに対して、「使いこなせている」と回答したのは全体の29.8%にとどまった。年代別に見ると若い層ほど自信を持っている傾向ははっきりしており、最も高かった18〜29歳でも46.6%と、半数には届いていない。電通総研は、対話型生成AIが身近になってきた一方、活用についてはまだ試行錯誤の段階にある人が多いと分析している(ただし29.8%はあくまで「使いこなせている」という自己評価の割合であり、実際の活用度を客観的に測った数値ではない点には注意したい)。

    自信ある人ほどAIエージェントに前向き

    調査では、AIエージェント――利用者の目的に応じて、資産運用などの金銭管理や、出会いのきっかけづくり、レストラン・旅行の予約といった作業を代行する自動支援サービス――を、実際にそうした場面で任せられるかどうかも尋ねている。その結果、「AIをうまく使いこなせている」と回答した人の方が、3つの場面すべてで「任せることを受け入れられる」と答えた割合が高かった。自信がある人ほどAIエージェントにも前向きという関連が見られるものの、これはあくまで回答傾向の相関であり、自信が受容度を高めたと言い切れるわけではない。

    不安は7.8ポイント増、年代差縮小

    一方で、使いこなせているかどうかに関わらず広がっているのが、仕事を奪われることへの不安だ。現在働いている人(2026年はn=5,734、2025年はn=5,708)を対象に尋ねたところ、「不安を感じている」と答えた割合は30.9%で、前年の23.1%から7.8ポイント増えた。前年は不安を感じる人が若年層に偏っていたのに対し、今年は40代から70代でも不安を感じる割合が増加し、結果としてどの年代も3割前後まで近づいた。電通総研はこの背景として、この1年で職場におけるAI活用が進んだ可能性を挙げているが、これは調査機関による解釈であり、今回の調査結果だけで因果関係が実証されたわけではない。

    仕事を奪われる不安を感じている就労者は30.9%――1年で7.8ポイント増え、年代による差は縮まった。
    AIを使いこなせている割合と、仕事を奪われる不安を感じる割合の変化を示す棒グラフ
    出典: 電通総研「クオリティ・オブ・ソサエティ指標2026」のデータをもとに作成

    過去のAI実験とも共通する問題意識

    「使いこなせている」という自信を持てる人がまだ少数派にとどまる一方、「仕事が奪われるかもしれない」という不安だけは年代を超えて広がりつつある。本サイトで以前紹介した、カリフォルニア大学バークレー校などの研究チームによる実験では、AIの助けを借りて問題を解いた人が、その後AIなしで取り組んだ課題で成績を落とす傾向が報告されていた。あちらは特定の課題での成績を測った実験、今回は人々の意識を尋ねた調査と、裏づけの種類は異なるものの、AIとの距離感に戸惑う人が広い年代で増えているらしい、という共通の手がかりとして読める。

    職場のAI浸透と学ぶ機会の課題

    職場でのAI活用が今後も広がるなら、企業には従業員がAIの使い方を具体的に学び、安心して試行錯誤できる環境を整えることが求められそうだ。今回の調査だけでは、不安が増えた原因や、学ぶ機会が実際に足りているかどうかまでは分からない。それでも、AIを使いこなせているという自信が広く行き渡っていない一方で、仕事への不安が年代を超えて強まっていることは、企業がAI導入と人材育成をセットで考える必要性を示唆していると言えるだろう。

    出典: 電通総研「クオリティ・オブ・ソサエティ指標2026」プレスリリース、同調査レポート(PDF)

  • 【科学】認知オフローディングとは?3分でわかる仕組みと注意点

    【科学】認知オフローディングとは?3分でわかる仕組みと注意点

    予定をスマホのリマインダーに任せる。長い報告書を自分で読む代わりにAIチャットボットに要約させる。こうした行動は心理学で「認知オフローディング(Cognitive Offloading)」と呼ばれます。この習慣自体は大昔からあるものですが、近年の研究は「道具が手元にないとき、自分の実力はどうなっているのか」という、より踏み込んだ問いを投げかけ始めています。

    元論文情報
    原題: Cognitive Offloading
    著者: Evan F. Risko, Sam J. Gilbert
    掲載誌: Trends in Cognitive Sciences, Vol. 20, No. 9, pp. 676–688 (2016)
    DOI: 10.1016/j.tics.2016.07.002

    認知オフローディングとは何か

    認知オフローディングとは、身体的な動作や外部の道具を使って、本来なら頭の中だけで行う作業の負担を減らすことです。カナダ・ウォータールー大学のエヴァン・リスコ氏と、英UCLのサム・ギルバート氏が2016年に学術誌『Trends in Cognitive Sciences』で発表したレビュー論文が、今もこの分野で最も参照される枠組みです。問題を完全に「頭の中」だけで解くのではなく、作業の一部を体や周囲の環境に肩代わりさせる、という考え方です。

    スマートフォンよりはるかに古い行動でもあります。逆さまの文字を読むために頭を傾ける、指を折って数える、電話番号を紙切れにメモする――これらもすべて認知オフローディングの一種です。変わったのは道具の規模と性能で、電卓やGPS、検索エンジン、そして生成AIアシスタントが、一連の思考プロセスそのものを肩代わりできるようになりました。この考え方は、哲学者アンディ・クラークらが1998年に提唱した「拡張された心(extended mind)」という理論とも近い関係にあります。いつも持ち歩くノートは、実用上その人の記憶システムの一部になりうる、という主張です。

    仕組み:スイッチではなく意思決定のループ

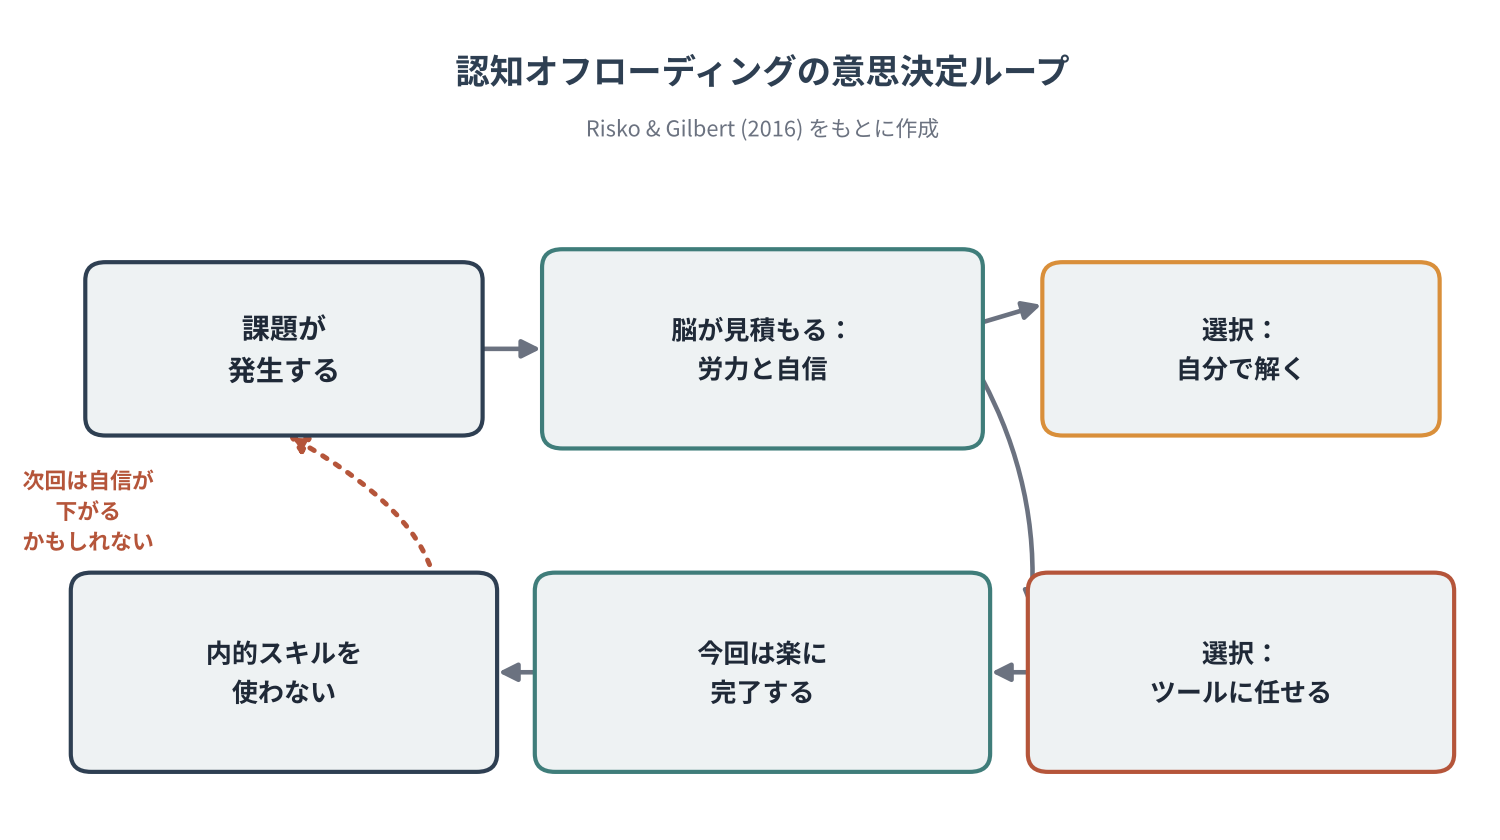
    帰り道に5つの用事を覚えておくよう頼まれた場面を想像してください。すべて頭の中で保持することもできますし、書き出すこともできます。リスコ氏とギルバート氏の枠組みでは、これを一度きりの選択ではなく、常に走り続けるコスト・ベネフィット計算の結果として捉えます。判断材料は、作業がどれだけ大変に感じられるか、自分の記憶力への自信、そしてリストを書く手間がどれだけ労力を節約するか、です。

    重要なのは、この計算が働くのは「実際の能力」ではなく「本人が感じる負担」と「自信」だという点です。自己評価は的外れなこともあり、本当は自力で対応できる場面でも外部の助けに頼ってしまうことがあります。道具への依存を繰り返すことで長期的に自信や素の実力が変化するのかは、関連はしていても別の、より検証が難しい問いです。オフロード自体が悪いわけではなく――忙しい週に買い物リストで記憶を補うのは理にかなった選択です――ただ、無意識の習慣になっていないか気に留める価値はあるでしょう。

    認知オフローディングの意思決定ループを示す図
    出典: Risko & Gilbert (2016), Trends in Cognitive Sciencesをもとに作成

    なぜ今あらためて注目されているか

    認知オフローディング自体は何十年も研究されてきたテーマですが、生成AIの登場によって、ニッチな学術トピックから一般的な関心事へと広がりました。2011年に『Science』誌に発表されたベッツィー・スパロウ氏らの研究はよく知られています。情報がオンライン上でいつでも参照できると信じると、人は情報の中身より「どこにあるか」をよく覚えている――いわゆる「グーグル効果」です。ただしこれはあくまで有益な歴史的類推です。検索エンジンは主に情報を保存・検索するだけですが、AIアシスタントは推論のような処理や文章の下書き、要約までこなします。研究者たちもこの違いを独自のテーマとして研究を始めたばかりです。

    研究者が今問うているのは、人がAIに思考を委ねるかどうかではなく、AIが手元にないときに自分の判断力をどれだけ失っているか、ということだ。

    2025年に『Societies』誌に掲載されたマイケル・ゲルリッヒ氏の研究は、666人を対象に、AIツールを頻繁に使う人ほど批判的思考力のスコアが低いという統計的に有意な負の相関を報告しました。特に若くAI依存度が高い層ほどスコアが低い傾向でした。ただし同じ時点で両方を測定した横断的研究のため、AI利用が思考力を弱めているのか、もともと能力の異なる人が使い方を変えているだけなのかは見分けられません。それでも同じ問いを別角度から示す研究は積み重なりつつあります。

    身近な具体例

    認知オフローディングは、自覚している以上に日常のあちこちに現れます。買い物リストを書いて記憶に頼らない、スマホのカレンダーにすべての予定を管理させる、経路を覚える代わりにGPSナビに目的地を打ち込む、事実を思い出す代わりに検索エンジンに尋ねる――どれもよくある例です。多くの場合、この取引は十分に見合うもので、買い物リストは記憶力をそれほど犠牲にせず用事を終わらせる助けになります。研究者が関心を持つのは、どのタイプのオフロードがこの「割に合う取引」に近く、どのタイプが後々の自力での実力により大きな代償を伴うのか、という点です。

    2020年に『Scientific Reports』誌に発表された、マギル大学のルイーザ・ダマニ氏らの研究は、この取引をGPSで直接検証しました。日常的に運転する50人の調査で、GPSの利用頻度が高い人ほどGPSなしでの空間記憶の成績が弱い傾向が見られ、約3年後に13人を再調査したところ、GPS利用がより増えた人ほど低下も大きいという対応関係も確認されました。著者らはこれをGPS利用が低下を招く方向の説明として支持しつつも、サンプルが小さく因果関係は完全には決着していないと注意を促しています。

    記憶だけがオフロードの対象ではありません。物の位置を覚える代わりに指でさすといった身体へのオフロードや、付箋やスマホの通知に「後で行動を思い出す」役目を託す「意図のオフロード」もあります。似て非なる概念が「自動化」で、利用者の判断を介さずシステムが作業を完結させる仕組みです。聞かずに経路を変更するGPSアプリは単純なオフロードを超えており、自分で判断を下す機会がなくなったときスキルがどうなるかは、また別の問いです。

    最新の研究動向

    最近の研究で最も明快な実証例が、2026年発表のカリフォルニア大学バークレー校主導の研究です。研究チームは計1,222人を対象に、ChatGPTを使える条件・使えない条件で数学や読解の問題を解かせる3つのランダム化比較試験を実施し、その後全員が最後の問題セットを完全に自力で解きました。結果、それまでAIに頼っていた参加者は最初から自力だった参加者より成績が明らかに低くなりました――ある実験では正答率57%対73%です。関連記事: AIに10分頼ると「粘り強さ」が落ちる――バークレー大学の実験で判明に詳しい結果と限界が整理されています。

    だからといって、オフロードが単純に悪いわけではありません。同じ研究の自己申告に基づく(ランダム化されていない)分析では、AIの答えをそのまま書き写したと答えた参加者の正答率は平均65%と最も低く、ヒント程度にしか使わなかった参加者はAI不使用の参加者に近い成績でした。確定的な結果とは言えませんが、示唆に富む傾向です。見えてくるのは、「オフロードするかどうか」より「どう使うか」が重要だというテーマです。完成した答えへの近道として使うのと、自分で考える過程を保つ足場として使うのとでは、効果の現れ方が違うようです。

    出典: Risko & Gilbert, “Cognitive Offloading,” Trends in Cognitive Sciences (2016)、Gerlich, “AI Tools in Society,” Societies (2025)、Columbia News(Sparrow et al., Science, 2011の紹介記事)、American Psychological Association Monitor (2026)

    あわせて読みたい: AIに10分頼ると「粘り強さ」が落ちる、AIの要約が記憶を歪める。

  • 【科学】脳は自ら学習回路を組み立てる?――MIT、AIと脳をつなぐ40年来の謎に新仮説

    【科学】脳は自ら学習回路を組み立てる?――MIT、AIと脳をつなぐ40年来の謎に新仮説

    脳とAI研究の間には、何十年も解けないままの食い違いがある。現在のAIの強さを支えるのは「バックプロパゲーション(誤差逆伝播法)」というアルゴリズムで、誤差の情報を出力側から入力側へ、層をまたいで正確に伝え返すことで学習を進める。ところがこれに対応する仕組みは、脳の中にはっきりとは見つかっていない。一方で、学習済みの人工ニューラルネットワークの内部活動と、生物の視覚系の活動パターンを比べると、興味深い類似が繰り返し報告されてきた。脳がバックプロパゲーションをそのまま行っているとは考えにくいのに、なぜ結果だけはそれによく似てくるのか――この問いに、マサチューセッツ工科大学(MIT)マクガバン脳研究所の新しい研究が、一つの答え方を示した。ランダムに結合しただけの「ニューロンもどき」の集まりに、生物学的にもっともらしい局所的な可塑性ルールだけを与えておくと、誰にも教わらずに、バックプロパゲーションに近い性能で学習できる回路へと自ら組み上がっていくというのだ。研究は2026年10月9日、米科学アカデミー紀要(PNAS)に掲載された。

    原論文情報 / Original Paper
    原題(Title): How Biological Synapses Self-Assemble Gradient Learning
    著者(Authors): Qianli Liao, Liu Ziyin, Yulu Gan ほか
    掲載誌(Journal): Proceedings of the National Academy of Sciences(PNAS)
    DOI: 10.1073/pnas.2606245123

    脳とAI、40年来のズレ

    現在の深層学習はほぼすべて、バックプロパゲーションという学習法の成功の上に成り立っている。ネットワークが予測を出し、正解との誤差を出力側から入力側へ層ごとに送り返しながら、誤りを減らす方向へ結合の重みを調整していく。この方法は驚くほどうまく機能するが、標準的な実装では、順方向と逆方向の結合のあいだに厳密な数学的対応関係が必要で、誤差の情報をネットワーク全体へ協調して伝える仕組みも要る。大脳皮質の回路がこれに相当する仕組みを備えているという確立された証拠は、今のところ見つかっていない。

    研究が進むにつれ、この謎はむしろ深まった。バックプロパゲーションで訓練したネットワークの内部活動と、生物の視覚系で記録された活動パターンを比べる研究では、偶然とは言えない類似が繰り返し報告されてきたからだ。脳がバックプロパゲーションを実行している証拠にはならないが、素朴な疑問が残る。脳が本当にそれをしていないなら、どんな局所的な仕組みがこれほど似た計算を生み出しているのか。

    ランダムな結合に、局所ルールだけ

    MITのチームは、Qianli Liao氏、Liu Ziyin氏、Yulu Gan氏が中心となり、Mark Harnett氏とTomaso Poggio氏がシニア著者として、Brian Cheung氏も加わって研究を進めた。バックプロパゲーションを「もっと生物学的にする」という従来の試みとは違い、あらかじめ回路を設計するのではなく、ほぼ何もない状態から出発した。多層に並んだ「ニューロンもどき」のユニットを、決まった配線図なしにランダムに結合させただけなのだ。

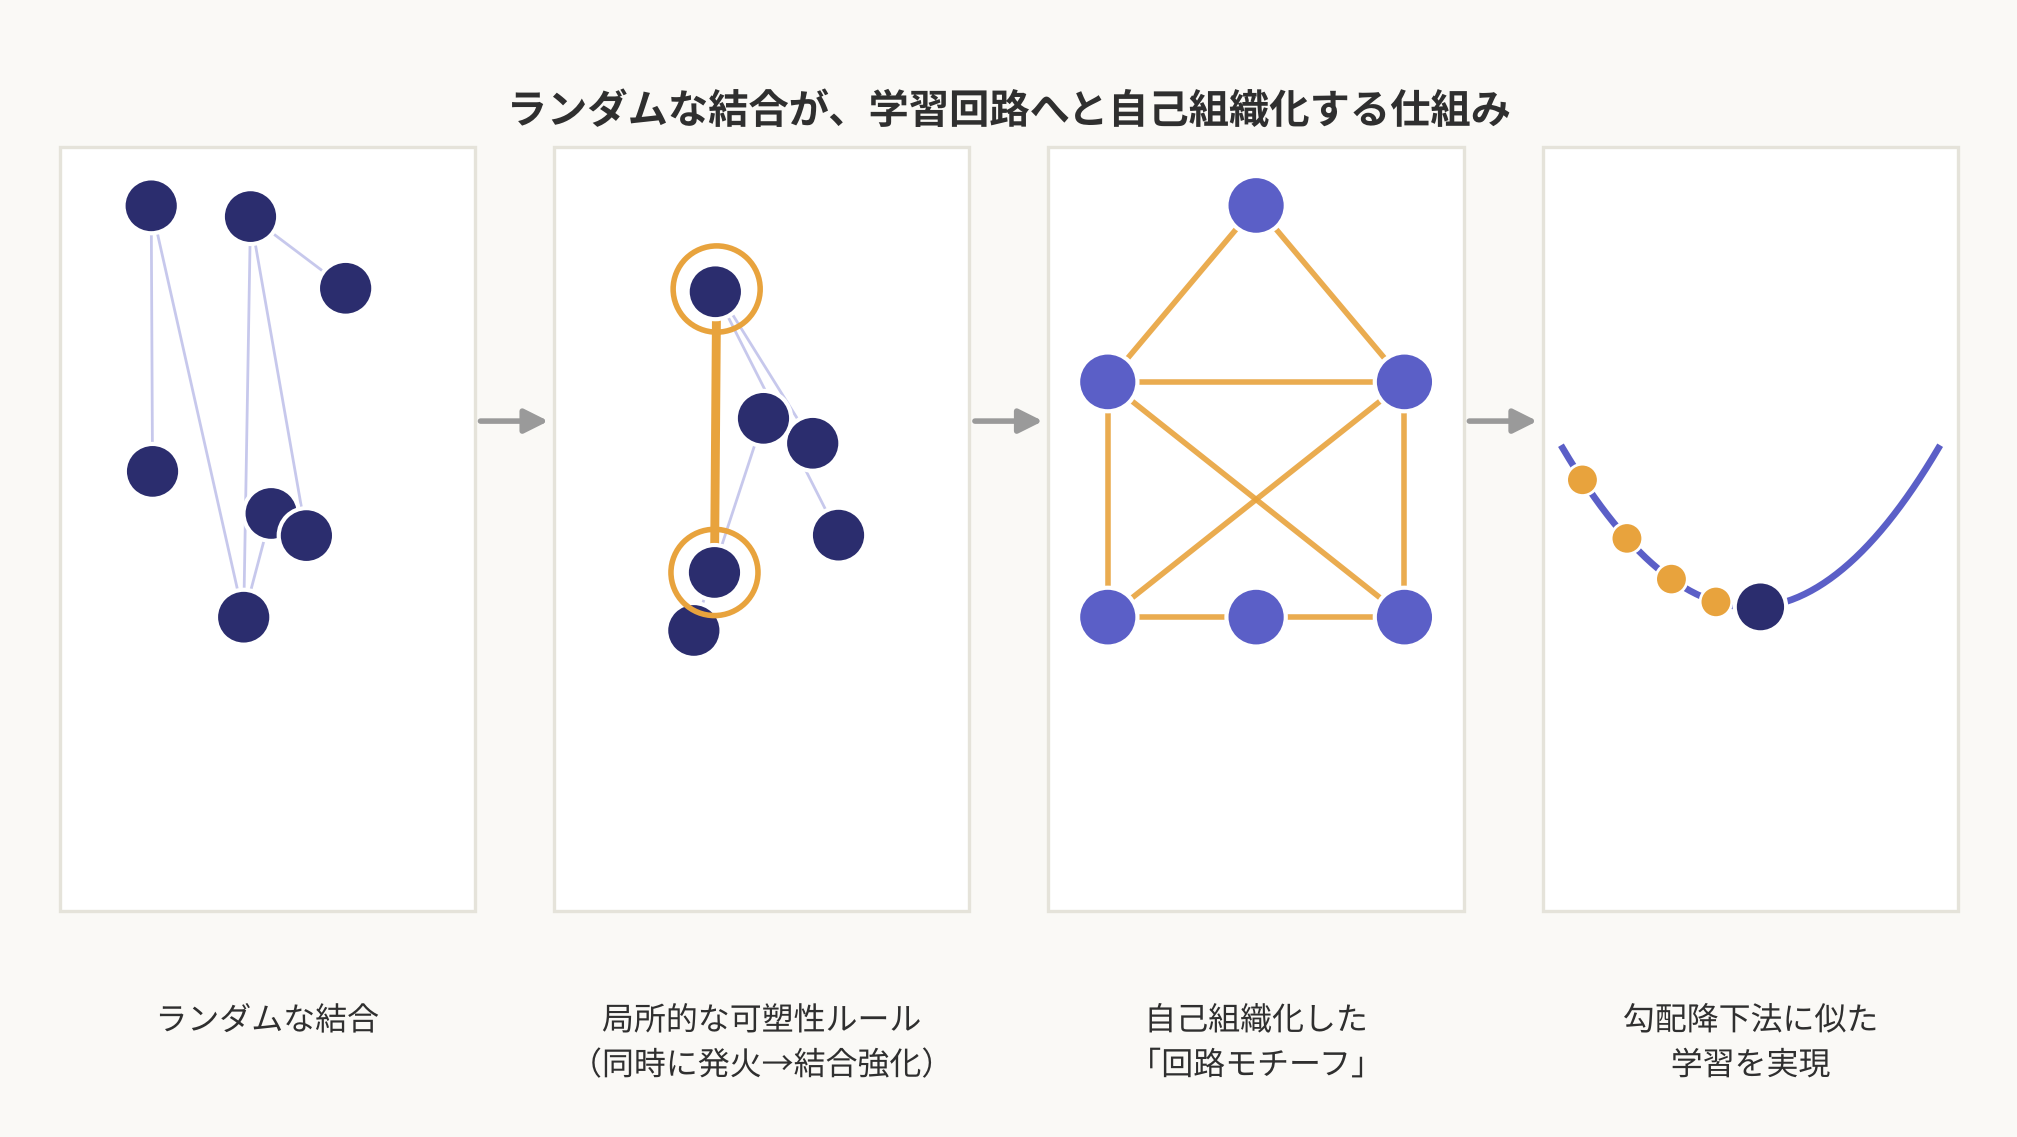
    このシステムが従うのは、シナプスの局所的な可塑性ルールで、一つのシナプスだけでなく周辺の活動に応じて結合が変化する「ヘテロシナプス可塑性」という仕組みも含まれる。これは「同時に発火した細胞同士の結合が強まる」というおなじみのヘブ則の、より具体的な親戚にあたる。重要なのは、これらのルールが必要とする情報が、それぞれのシナプス(神経細胞どうしの接合部)の近くだけで得られる、ローカルな情報に限られている点だ。どのユニットもネットワーク全体の状況を知る必要はなく、システム全体に向けた単一の誤差信号が放送されることもない。

    ランダムな結合が学習回路へと自己組織化する仕組みを示す図
    出典: MITマクガバン脳研究所 / PNAS(2026年)の報告をもとに作成

    自ら組み上がる「回路」

    局所ルールのもとで動かし続けると、ランダムに結合していたユニットは、ランダムなままではいられなくなる。活動が繰り返されるうちに、ネットワークの中に、研究チームが「自己組織化モチーフ」と呼ぶ、小さく繰り返し現れる配線パターンが育っていった。モデルの解析によれば、脳の「上行性(ボトムアップ)」経路と「下行性(トップダウン)」経路を結ぶ、4つのシナプスからなる特定のモチーフが浮かび上がるという。これは実際の脳組織ですでに確認されたパターンではなく、実験神経科学者がこれから探しにいける、具体的な構造上の予測だと位置づけられている。

    さらに興味深いのは、このモチーフたちがその後に何をするかだ。モチーフ同士がネットワークとしてさらに自己組織化し、その全体の振る舞いが、確率的勾配降下法――バックプロパゲーションを含む最適化手法の一群――を一般化したようなダイナミクスに近づいていく。しかもそれは、誰かが設計した統括アルゴリズムによってではなく、局所的な結合ルールの積み重ねだけで実現される。言い換えれば、このネットワークは訓練データから何かを学ぶ前に、まず自分自身が学ぶための「装置」を組み立てる必要があったのだ。

    ランダムな結合から出発しても、局所的なシナプス可塑性ルールだけで、組み合わさると勾配降下法に似た学習を実現する回路モチーフを組み立てるには十分だった。

    AIの学習法に匹敵する成績

    生物学的にもっともらしい回路というだけでは、実際に機能しなければ意味がない。そこで研究チームは、この自己組織化したネットワークに画像のパターン認識・分類のタスクを解かせた。MITの発表によれば、自己組織化した回路は、同じタスクでバックプロパゲーションを直接使った従来型ネットワークに匹敵する性能を示したという。ただし発表文には具体的な正答率やベンチマークの詳細はなく、それらを知るにはPNAS論文本体にあたる必要がある。この結果は「今回試したタスクでは自己組織化が目立った代償を伴わなかった」という証拠であり、深層学習全般でバックプロパゲーションに匹敵するという一般論として読むべきではない。

    それでも意味は大きい。生物学に着想を得たバックプロパゲーションの代替案は、これまで実際のタスクでは性能面で及ばないことが多かったからだ。ランダムな配線から自己組織化しながら、少なくとも今回のタスクで渡り合える回路の存在は、その差を一例に限ってではあるが縮めて見せた。

    脳で検証できる具体的な予測

    研究チームは、このネットワークが学習できるからといって、人間の脳が実際にこの方法で学習していると証明されたわけではない、と慎重に断っている。あくまで候補となる仕組みの一つであり、確定した答えではない。ただし計算論的神経科学の理論提案の多くとは違い、今回の研究には具体的で反証可能な予測が伴う。もし脳が本当にこれに近いことをしているなら、大脳皮質の回路には、上行性と下行性の経路を結ぶ、あの4シナプスのモチーフが存在するはずだ、というものだ。実験神経科学者は今、まさにそのような配線の痕跡を、実際の脳組織の中に探しにいくことができる。エレガントなシミュレーションを、検証可能な科学的仮説へと変える一歩だと言える。

    研究室の外への広がり

    予測が裏づけられれば、恩恵は両方向に広がりうる。神経科学にとっては、学習回路の存在が確認されれば、脳が生涯を通じてどう適応するかの手がかりとなり、学習や記憶に関わる不調の理解や、将来の脳とコンピュータをつなぐインターフェース設計にも生かせるかもしれない。ただしこれらはまだ実証された成果ではなく、今後の可能性にとどまる。

    AI研究にとっての教訓は、むしろ逆向きだ。現在のネットワークは、どの結合をどう学習させるかをエンジニアがあらかじめ設計する、トップダウンの発想でつくられている。ランダムな配線と局所的な可塑性ルールだけから学習機構を組み立てられるシステムは、データに触れながら自らを構成していく、別のアーキテクチャの可能性を示す。Liao氏らも、結果はその方向への最初の一歩に過ぎないと位置づけつつ、すでに組み上がったネットワークがどう学ぶかだけでなく、学習そのものをどう「あらかじめ組み込んでおける」かという新しい問いを残した。

    人工知能と生物の知能がどこで今もすれ違っているのかについては、人は何かを選んだ後、脳の中の「情報の並べ方」を組み替えていた――MITの発見、柔軟に学習するAI設計の参考にで紹介した、MITの別の研究も参考になる。意思決定の瞬間に脳が情報を並べ替えるという発見で、AI研究者が柔軟な学習のあり方を考え直すきっかけになっている。

    Xsciens編集部の読み解き

    脳とAIの学習の食い違いに対して、「回路を設計せず、ランダムな結合から自己組織化させる」という別の答え方を示したのが、この研究の特徴です。

    • シミュレーション上の結果であって、脳での確認ではない。ランダムに結合したユニットが局所ルールだけで学習回路を組み上げるのは、モデルの中での話です。人間の脳が実際にこの方法で学習しているとは、記事にあるとおり証明されていません。
    • 「匹敵する性能」は限られた条件の話。画像のパターン認識・分類のタスクで、バックプロパゲーションを直接使った従来型ネットワークに匹敵したとされますが、具体的な正答率はMITの発表文に示されていません。深層学習全般に当てはまる一般論としては読めません。
    • この研究の価値は、検証できる予測を出したこと。上行性と下行性の経路を結ぶ4シナプスのモチーフが実際の大脳皮質にあるかは、実験で調べられます。見つかれば仮説の支持に、見つからなければ修正の材料になります。

    この読み解きの参考: MIT News の解説、原論文(PNAS)

    出典: MIT News、Proceedings of the National Academy of Sciences(PNAS)、arXivプレプリント

    あわせて読みたい: AIの学習の仕組みを基礎から知りたい方はバックプロパゲーションとは?3分でわかる仕組みと将来性をどうぞ。

  • 【科学】AIに10分頼ると「粘り強さ」が落ちる――バークレー大学の実験で判明

    【科学】AIに10分頼ると「粘り強さ」が落ちる――バークレー大学の実験で判明

    AIチャットボットに答えを出してもらうと、難しい問題もあっという間に解けたように感じる。しかしそのAIが手元からなくなった瞬間、話は変わってくる。カリフォルニア大学バークレー校などの研究チームが発表した実験で、AIアシスタントを使って問題を解いていた人は、AIが取り上げられた後に出された次の問題で、最初から自力で取り組んでいた人よりも成績が落ち込むことが分かった。その差は10〜15分程度AIの助けを借りて問題に取り組んだだけで現れ、合計1,222人が参加した3つの実験すべてで確認された。研究チームは、AIに答えを頼ることが、自力で問題を解く力や意欲そのものを損なう可能性があると指摘している。

    3つの実験、共通する結果

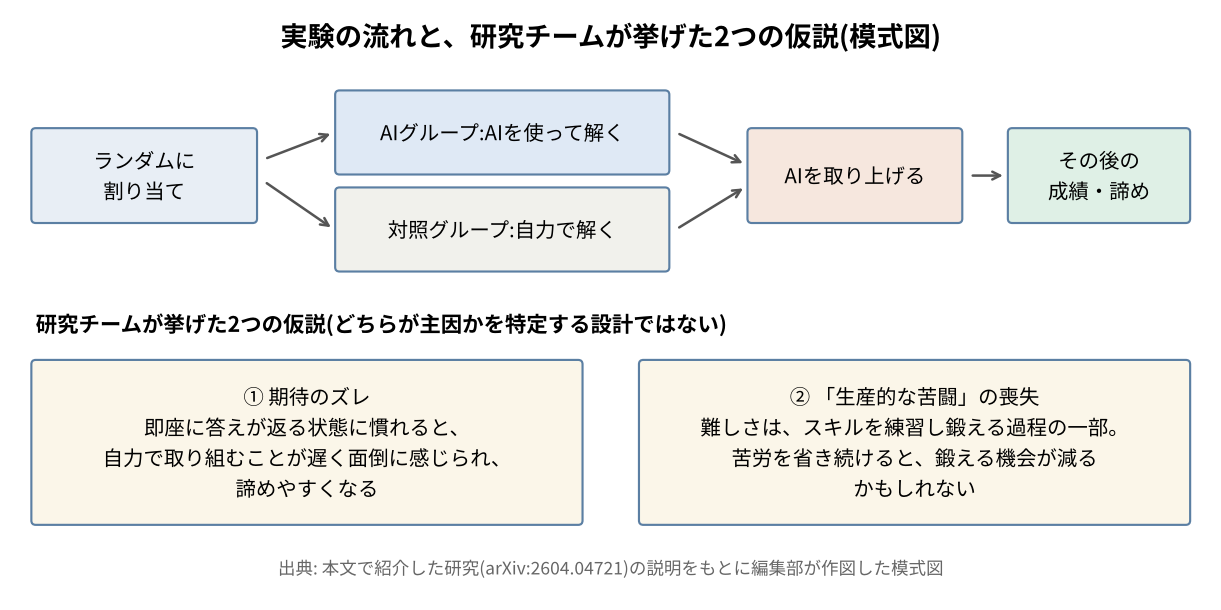
    研究チームは、バークレー校「人間に適合したAIセンター」のグレース・リウ氏とブライアン・クリスチャン氏を中心に、カーネギーメロン大学、MIT、オックスフォード大学、UCLAの研究者と共同で、計1,222人が参加する3つのランダム化比較試験を実施した。最初の実験では354人が、GPT-5搭載のChatGPTを使える条件と使えない条件に分かれて12問の分数問題に取り組み、その後、AI群を含む全員が残り3問を完全に自力で解いた。2つ目の実験は667人で同じ設計を繰り返し、3つ目の実験では201人が、数学の代わりにSAT形式の読解問題で同様の検証を行った。

    どの実験でも、序盤の結果は想像どおりだった。AIを使える間は、AIを使ったグループの方が自力のグループよりも速く、正確に問題を解いていた――有能なアシスタントがいれば当然の結果だろう。しかし物語の核心は後半にある。AIが取り上げられ、AIを使っていたグループも含め、全員が残りの問題を自力で解かなければならなくなってからだ。

    数字が示す結果

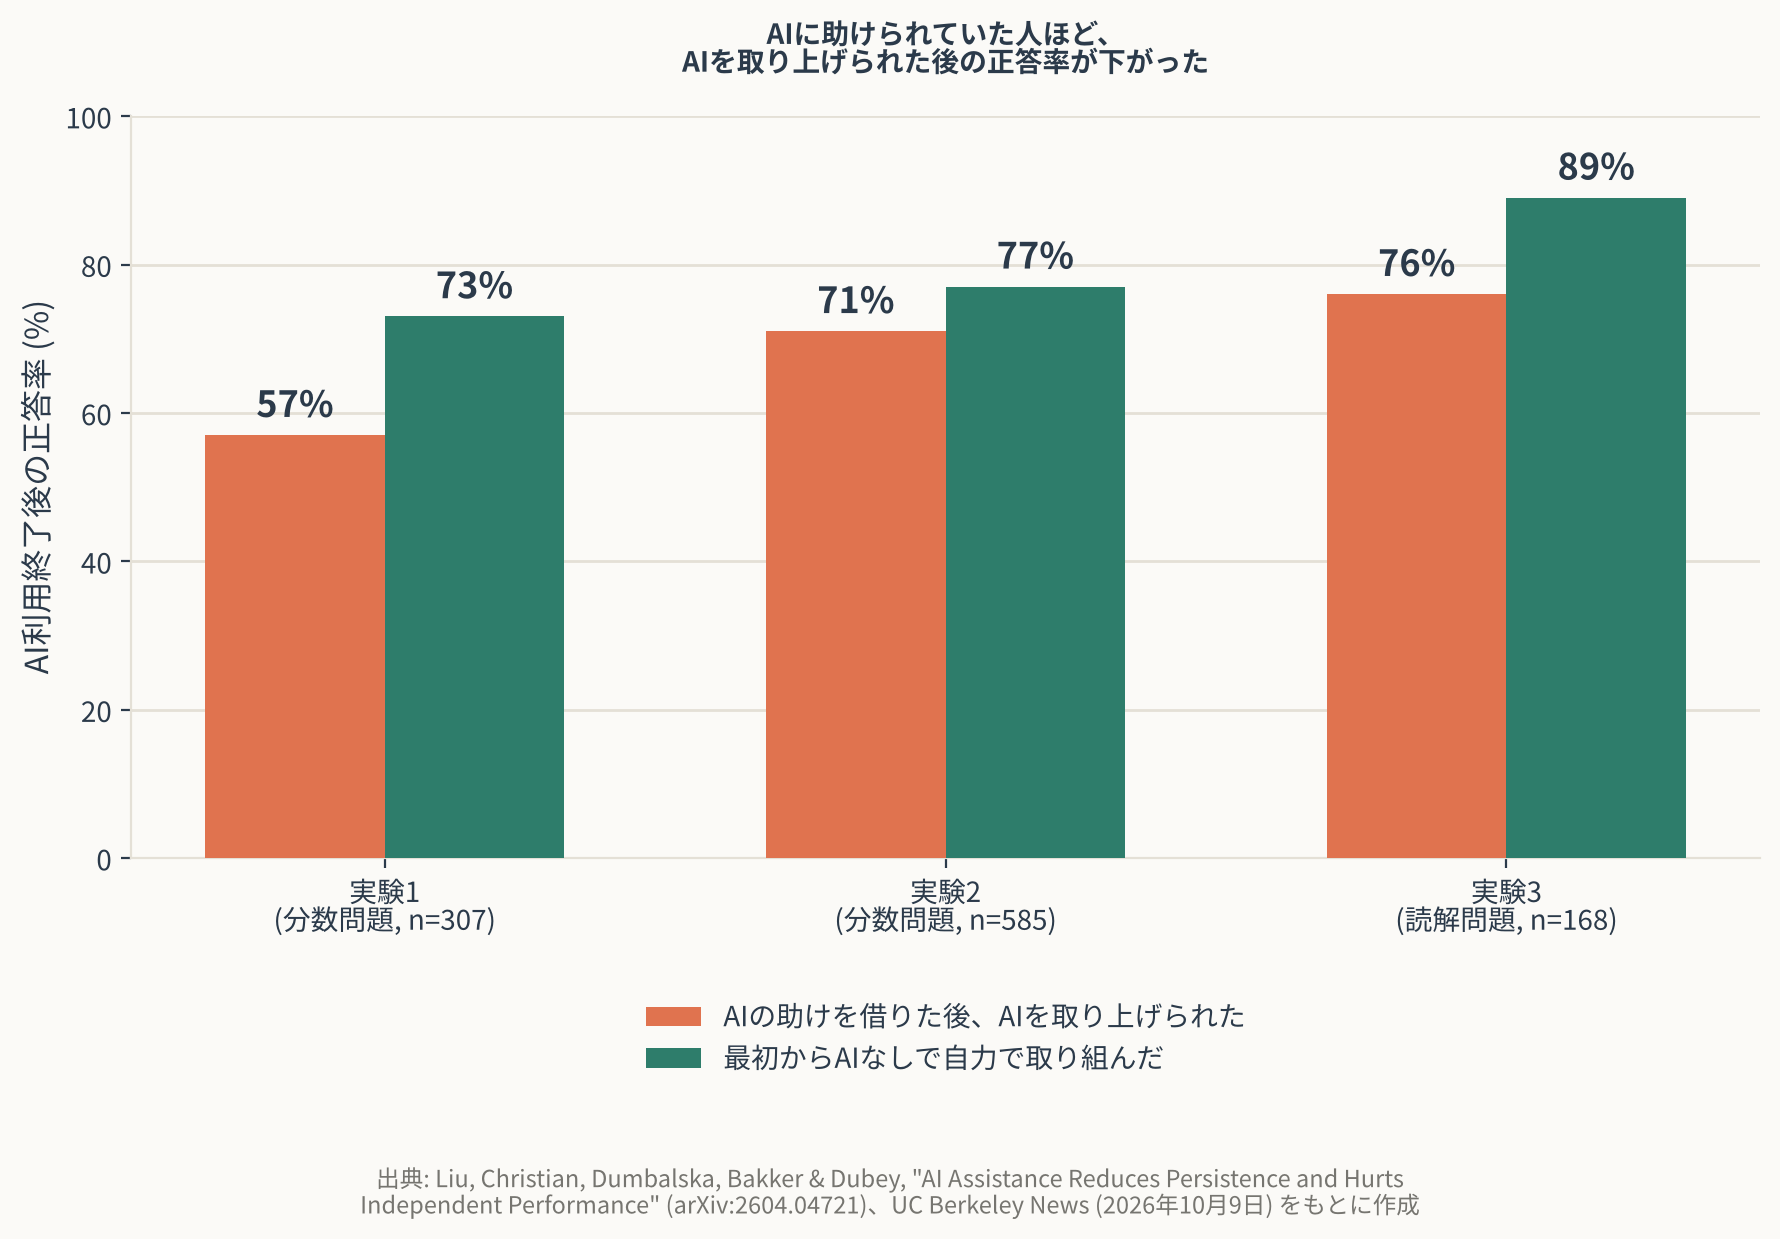
    AIが使えなくなった後、かつてAIを使っていたグループは、最初から自力だったグループに後れを取るようになった。この傾向は3つの実験すべてで一貫して見られた。最初の分数の実験では、元AIグループが残り3問のうち平均57%を正解したのに対し、AIなしグループは73%――統計的に有意な差だった(p<0.001)。同じ設計をより大規模に繰り返した2回目の実験では、差はやや縮まったものの依然として有意だった(71%対77%、p=0.02)。読解問題の実験では差が再び広がり、76%対89%となった(p=0.007)。

    AIが取り上げられた後の正答率を3つの実験で比較した棒グラフ
    出典: Liu, Christian, Dumbalska, Bakker & Dubey (arXiv:2604.04721)、UC Berkeley Newsのデータをもとに作成

    問題を完全に諦めてしまう割合にも、同様の傾向が見られた。最初の実験では、元AIグループの20%が問題を解こうともせず飛ばしたのに対し、AIなしグループは11%だった。大規模な2回目の実験ではこの差はやや弱まったが(10%対7%、統計的有意差なし)、読解問題の実験では再びはっきりと現れ、AIグループの8%が問題を飛ばしたのに対し、AIなしグループはわずか1%だった。参加者の自己申告にもとづきAI利用法を見ると、傾向はさらに鮮明になる(ランダム化ではなく自己選択による分析である点には注意)。答えをそのまま書き写していたと答えた人はその後の正答率が平均65%と最も低く、ヒント程度にしか使わなかったと答えた人は、AIを一切使わなかった人との間に有意な差が見られなかった。

    参加者はAIあり・なしの条件にランダムに割り振られ、2回目の実験の事前テストでも両グループの実力に有意な差はなかった――後の成績差が参加者の元々の実力差ではなく、AI条件そのものに起因することを裏付ける結果だ。さらに同じ実験では、AIを使える環境にいながらほとんど使わなかった人が約12%おり、その成績はAIを一切使えなかった人たちとほぼ同等だった。鍵を握るのは「AIが使えるかどうか」ではなく「どれだけ頼ったか」のようだ。

    「衝撃的な結果だが、ある意味で、私たちの多くが直感的に感じていた話を裏付けるものでもある」――ブライアン・クリスチャン氏(カリフォルニア大学バークレー校)

    何が原因と考えられるか

    研究チームは2つの仮説を示しているが、どちらが主な要因かを特定する設計にはなっていないと断っている。1つ目は「期待のズレ」だ。即座に答えが返ってくることに慣れてしまうと、自分の手で地道に問題に取り組むことが不釣り合いなほど遅く、面倒に感じられ、簡単に諦めてしまいやすくなるという考え方だ。2つ目は、研究者が「生産的な苦闘」と呼ぶものの喪失である。問題の難しさそのものは単なる障害物ではなく、人がその問題に必要なスキルを練習し、鍛えるための過程の一部だという考え方だ。この苦労を省略し続けると、本来鍛えられるはずだったスキルを練習する機会そのものが減ってしまうかもしれない、というわけだ。

    AIグループと対照グループの実験の流れと、研究チームが挙げた2つの仮説の模式図
    実験の流れと2つの仮説の模式図(研究の説明をもとに編集部が作図)。

    メカニズムは異なるが、当サイトが以前取り上げた別の研究も、関連する問いを投げかけている。ジョージタウン大学の研究チームは、AIが作成した要約が実際に起きた出来事についての人の記憶をゆがめてしまうことを発見した。こちらは問題解決ではなく記憶についての研究だが、頭を使う作業をAIに任せるたびに、便利さの裏で気づかないうちに正確さや能力を失っていく可能性があるという点で、今回の研究と共通する問題意識がある。

    「分数やSATの話ではない」

    クリスチャン氏は、この結果が心理学の実験室の外にどこまで広がる話なのかについて率直に語っている。研究発表に添えられたコメントで、同氏は「これは分数やSATの問題だけの話ではない。人間の知識や専門性そのものに起きていることだ」と述べた。さらに、広く使われているAIアシスタントについて「皮肉なことに、私たちを助けているようでいて、実はあまり役に立たない形で助けていることが多い」と指摘する。目の前のタスクの成績は押し上げる一方で、データが示す限り、次にAIがそばにない場面で必要となる「自力で物事をこなす力」を、少しずつ損なっている可能性があるというのだ。

    注意点もある。測定したのはAIが取り上げられた直後、数分以内の成績であり、数カ月、数年の時間軸でこの効果がどう変化するのかは分かっていない。さらに3つの実験はいずれも、オンラインの有償参加者による短時間・一回限りの課題であり、学生が学期を通してAIを使い続ける場合や、社会人が日常業務に組み込む場合とは状況が異なる点にも留意したい。

    AIとどう付き合うべきか

    この結果は、AIの助けを一切使うべきではないという話ではない。同じデータは、AIが使える間は短期的な成績を明らかに押し上げていたことも示しており、多くの実務的な場面では、速く正しい答えにたどり着くこと自体に価値がある。この1つの研究から得られる教訓として参考になりそうなのは、AIを「使うかどうか」ではなく「どう使うか」だ。参加者の自己申告ベースの分析では、最も成績が落ち込んだのはAIに完成した答えをそのまま出してもらっていた人たちで、ヒントや部分的な手がかりとしてAIを使っていた人たちは、AIを一切使わなかった人たちにかなり近い成績を保っていた。AIを「答えを出す自動販売機」としてではなく、解決への道筋を少しずつ示してくれる「家庭教師」のように使うことが、自分の問題解決力を保つうえでは無難な選択肢と言えそうだ。ただし、これは分数と読解問題という限られた場面での1つの研究であり、この教訓がどこまで当てはまるのかは今後の研究を待つ必要がある。

    Xsciens編集部の読み解き

    見出しの「10分」は、短時間の依存でも成績差が出た点を指しますが、それが能力の恒久的な低下を意味するかどうかは、この実験では分からない点に注意が必要です。

    • 差はランダム割り付けの部分だけが因果の根拠。AIの有無は参加者にランダムに割り当てられており、AIが使えなくなった後の正答率の差はこの条件の違いから来ています。3つの実験で差は16ポイント(57%と73%)、6ポイント(71%と77%)、13ポイント(76%と89%)と、大きさにばらつきがあります。
    • 「答えの書き写し」の結果は参考値。書き写したと答えた人の正答率が65%と最も低かったという分析は、自己申告にもとづく自己選択の比較で、ランダム化されていません。AIの使い方そのものが原因だとは言い切れません。
    • 測られたのは「直後」の短い課題。オンラインの有償参加者による一回限りの課題で、数か月から数年の影響や、日常業務での使い方の効果は分かっていません。
    • 編集部の想像(推測)――私たちは、AIが「答えを出す」だけでなく、あえてヒントだけ出して考える時間を残す使い方に変わっていけば、便利さと粘り強さを両立できるかもしれないと考えています。たとえば勉強や仕事で、行き詰まったときだけ次の一手の手がかりをくれる、といった形です。ただし、今回の実験は数分以内の成績を測ったもので、そうした使い方が長期的に効くかどうかは分かっていません。これは編集部の推測です。

    この読み解きの参考: UC Berkeley News、論文(arXiv:2604.04721)

    出典: UC Berkeley News、arXiv:2604.04721「AI Assistance Reduces Persistence and Hurts Independent Performance」

    関連記事

    あわせて読みたい: AIに頼ることの影響を整理した解説は認知オフローディングとは?3分でわかる仕組みと注意点です。

  • 【科学】AIの要約が記憶を歪める――警察・目撃証言への警鐘

    【科学】AIの要約が記憶を歪める――警察・目撃証言への警鐘

    交差点に近づく車の短い映像を見て、標識を確認し、歩行者がはねられる場面を目撃したとする。翌日、その映像を要約したAIの文章を読む。ただし要約には、標識の種類を取り違える誤りが一つだけ紛れ込んでいた。後で「実際に見た標識はどちらか」と尋ねられると、正答率は目に見えて下がってしまう——これが、ジョージタウン大学とワシントン大学の研究チームが新たに示した結果だ。誤りを含むAI要約は、自分が直接目撃した出来事の記憶そのものを歪めうる。AIによる要約はすでに報道やオフィス業務、警察の捜査にまで広がりつつあるだけに、見過ごせない指摘だ。

    イメージ図

    AI要約はすでに身近な存在に

    ChatGPTやGeminiのような大規模言語モデルは、会議の録画やニュース映像、監視カメラ映像を数行の箇条書きに要約する用途ですでに日常的に使われている。米国の一部の警察では一歩進んで、ボディカメラの音声を文字起こしし、そこから報告書の文章案を自動生成するツールの導入も始まっている。代表例であるAxon社の「Draft One」は、通報対応後数分で報告書の下書きを作成し、最終的に警察官自身が内容を確認・承認する仕組みだ。米コロラド州フォートコリンズ警察では、導入後に報告書作成にかかる時間が82%減ったと報告されている。ただしこのツールは音声の文字起こしから文章を作る仕組みで、映像を要約する今回の研究対象とは異なり、今回の研究で直接検証されたわけではない。それでも、正確さが重要な場面にAIが書いた文章が急速に入り込みつつある現実を物語る。

    筆頭著者でジョージタウン大学の助教研究員、マッテア・シム氏は「AIは誤情報を広める新しい手段になっている」と指摘する。共著者で、警察とテクノロジーの関係を研究するワシントン大学のヤエル・アイガー氏は、「警察がこうした映像要約技術を、十分な検証もないまま使っている可能性があるのが気がかりだ」とさらに踏み込む。

    事故映像で記憶をテスト

    研究チームはまず、ChatGPT-5.5とGemini 2.5 Flash-Liteの2モデルに、車と歩行者の衝突を描いた短いアニメーション映像を要約させた。用意した映像は2種類で、内容はほぼ同一だが、交差点の標識だけが「一時停止」か「徐行」かで異なる。各モデルにそれぞれの映像を5回ずつ要約させ、合計20本の要約文を作成した。

    次に360人の参加者を募り、2種類のうちいずれか一方の映像を視聴してもらった。その1〜2日後、参加者は自分が見た映像の要約文を読む。要約は正確な内容のものか、標識の種類を取り違える誤りが一つだけ埋め込まれたもののいずれかで、さらに「AIが書いた」「人間の書き起こし担当者が書いた」のどちらかをランダムに伝えられた。360人のうち、両段階を完了し注意力チェックに合格したのは328人だった。

    要約の半数が核心を省略

    研究チームはまず、作成した20本のAI要約を、あらかじめ定めた「事故の核心にあたる情報」のリストと照らして採点した。結果は芳しくなく、要約は平均して核心情報の51.6%を省略し、20本中19本が最重要の事実である「車が歩行者をはねた」ことに触れていなかった。

    2モデルには違いもあった。標識の種類のような重要な事実を取り違える「致命的な誤り」は、Geminiの要約では100%の割合で見られたのに対し、ChatGPTでは30%にとどまった。両モデルとも、映像に存在しない内容を作り出す「ハルシネーション」と呼ばれる誤りも時折見られた。なおこれらの数値は2本の短い映像・2モデルという限られた条件での結果であり、AI要約全般の一般的な誤り率ではなく、「深刻な誤りが起こりうる」事例と捉えるべきだ。

    「AIには、敵意や悪意がなくても誤情報を生み出してしまう可能性がある」と、研究チームは論文に記している。

    誤った要約で正答率がほぼ半減

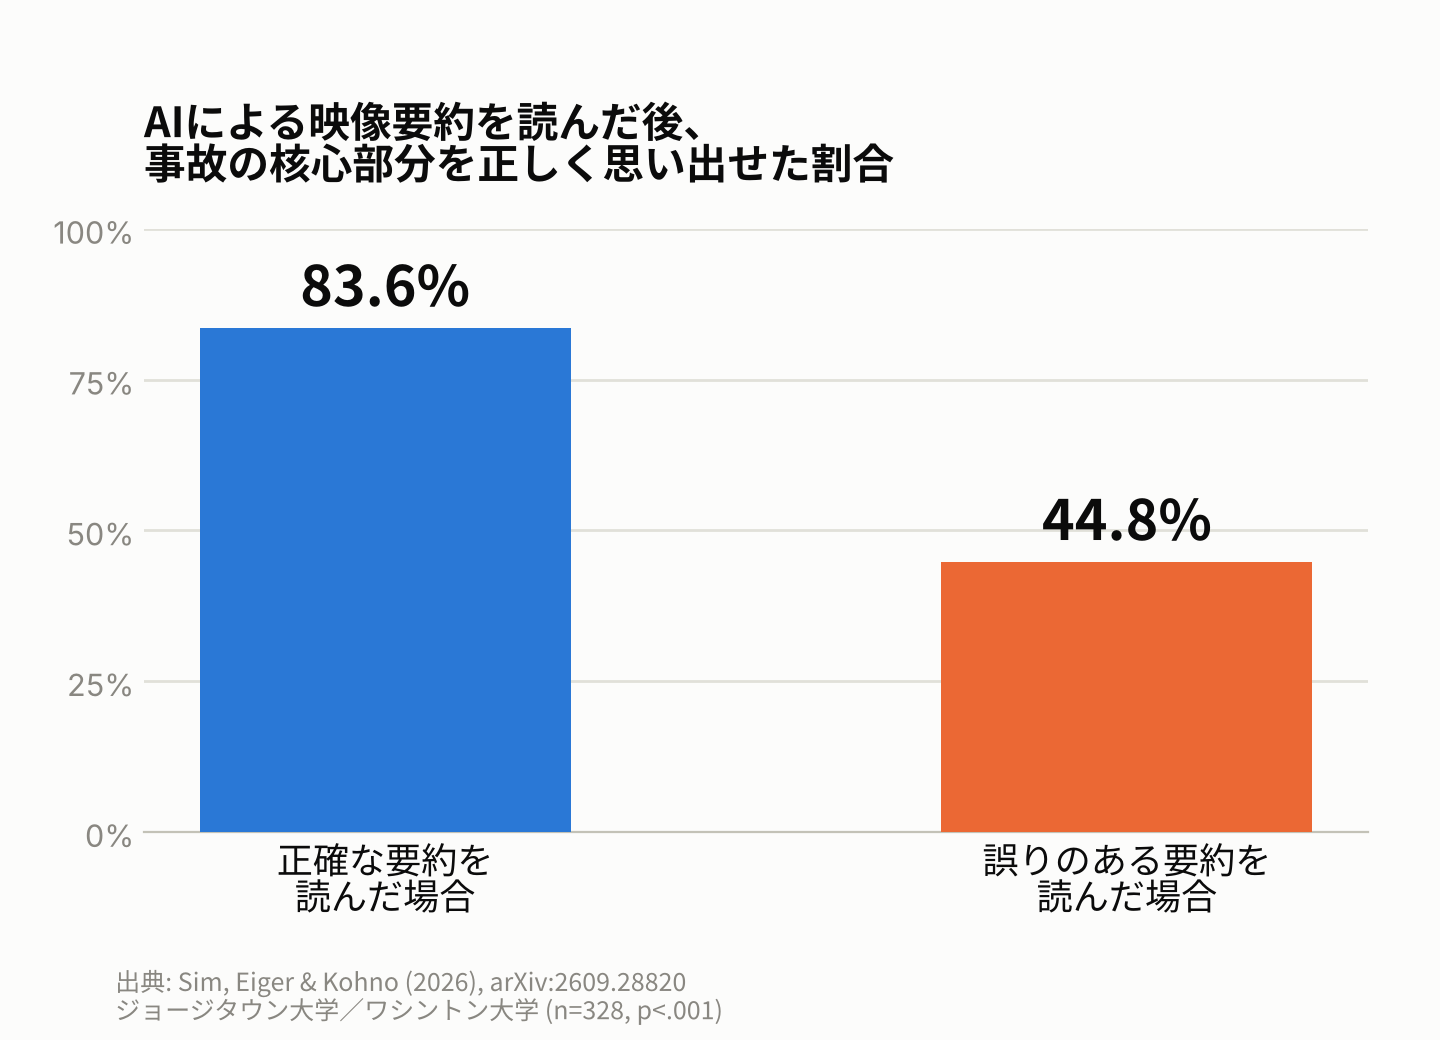
    2段階目の実験では、こうした誤りが要約の中だけにとどまらず、人が実際に見た出来事の記憶そのものに影響することが示された。正確な要約を読んだグループは、標識を問う質問に83.6%の確率で正しく答えられた。これに対し、誤りのある要約を読んだグループの正答率は44.8%にまで下がった。この差は統計的に有意で、単なる偶然では説明しにくいと研究チームは結論づけている。

    正答率を比較した棒グラフ

    この38.8ポイントの差こそが、今回の研究の核心的な発見だ。一見ごく普通の要約に紛れ込んだ、たった一つの誤った情報が、わずか1〜2日前に自分の目で見た出来事の記憶を大きく揺るがすのに十分だった。ただしこの実験が示すのは明確な「誤情報効果」であり、元の記憶が完全に消去・書き換えられたことまで証明するものではない。確かなのは、この特定の事実についての想起の正確さが大きく損なわれた、という点だ。

    AIだと伝えても効果なし

    興味深いのは「効かなかった要因」だ。要約を「AIが書いた」と伝えられたグループは、「人間が書いた」と伝えられたグループと比べて、誤りを見抜きやすいわけでも騙されにくいわけでもなかった。正答率はそれぞれ46.3%と43.4%で、統計的に意味のある差とは言えない。AIへの信頼度や利用頻度も、騙されやすさに測定可能な影響を与えなかった。

    つまり今回の実験の範囲では、要約に「AI製」とラベルを付けるだけでは誤りの影響は弱まらなかった。研究チームは、この結果が「人間が最終確認すればAIのミスは防げる」というAI安全性をめぐる一般的な前提に疑問を投げかけると指摘する。誤った要約が確認者自身の記憶を静かに書き換えてしまうなら、ミスに気づく手立てそのものが失われかねない。なお今回検証されたのは「誰が書いたかのラベル」だけで、元の映像と突き合わせて事実を確認するといった、より踏み込んだ手順の効果までは検証していない。

    司法と警察現場への教訓

    今回の実験で使われたのはアニメーション映像で、参加者も一般から募った被験者であり、実際の警察官や目撃者、実際の事件ではない。それでも警察現場に関連づけられる理由はより一般的なところにある。AIが生成した説明が、人が出来事を思い出す手がかりの一部になると、その誤りが後の記憶に影響しうるという点だ。警察官や目撃者が正式な供述の前に誤りを含むAI要約を読めば、その後の証言に影響が及ぶ可能性がある――現実的な懸念だが、今回の研究自体が直接検証したわけではない。

    これは人間側だけの弱点でもない。本サイトで以前取り上げた動きの錯覚に関する過去記事では、AIの画像認識が人間の目を惑わす「動きの錯覚」を同じようには再現しないことを報告した。AIと人間の知覚のズレは双方向に生じうるということであり、どちらか一方を鵜呑みにして他方の確認役にはできない。

    今回の研究の縮約版は今週、スウェーデン・マルメで開催中の「第9回AAAI/ACM AI・倫理・社会会議(AIES 2026、10月12〜14日)」で発表された。論文自体は9月にプレプリントとして先行公開済みだ。著者らはAI要約を重要な場面から一律に排除すべきだと主張しているわけではないが、法的判断に関わる場面で信頼される前に、誤り率を測定・開示する必要があると強調する。

    研究チームは未検証の点にも率直だ。使用したのはChatGPTとGeminiの一般消費者向け版のみで、Axonのようなベンダーが実際に使う企業向け・調整済みモデルは対象外だった。アイガー氏は、ベンダーが実際にどのモデル・設定を使っているか外部から見えにくいこと自体が問題だと話す。シム氏は次の一歩として、実際のボディカメラ映像と警察報告書を対象に、AI要約が警察と市民のやり取りへの人々の判断をどう左右するか調べたいとしている。

    Xsciens編集部の読み解き

    この研究が突きつけるのは「AIは間違える」という当たり前の事実より、間違いが人間の記憶そのものに入り込み、確認する側の判断を静かにゆがめうるという点です。

    • 38.8ポイントの差の前提を押さえる。正答率は、正確な要約を読んだ群で83.6%、誤りを含む要約を読んだ群で44.8%でした。ただし対象は、2本の短いアニメーション映像と2つのAIモデル、最終的に分析に残った328人という限られた条件です。AI要約全般の誤り率ではありません。
    • 「AI製」のラベルでは防げなかった。AIが書いたと伝えられた群の正答率は46.3%、人間が書いたと伝えられた群は43.4%で、意味のある差はありませんでした。一方、元の映像と突き合わせるなどの確認手順の効果は検証されていません。「人間が最終確認すれば安全」という前提を否定したというより、確認の方法を設計し直す必要を示した結果です。
    • 警察の実運用ツールを直接検証したものではない。記事にある警察向けツールは音声の文字起こしから文章を作る仕組みで、今回の研究は映像の要約が対象です。実際のベンダーが使う調整済みモデルも検証されていません。
    • 編集部の想像(推測)――私たちは、将来のAI要約が「この一文は映像の何秒目に基づく」と根拠の場面をその場で示してくれるようになれば、確認の手間が減り、誤りに気づきやすくなるかもしれないと考えています。たとえば会議の録画を要約するとき、気になる一文を押すと元の発言に飛べる、といった使い方です。ただし、根拠が示されても人が確認を省けば同じ問題は残りうるので、これはあくまで編集部の推測です。

    この読み解きの参考: ジョージタウン大学の発表、論文(arXiv:2609.28820)、Loftus & Palmer(1974)の古典実験の解説(SimplyPsychology)

    出典: ジョージタウン大学 “New Research Finds That Misleading AI-Generated Summaries Can Distort Human Memory”、Sim, Eiger & Kohno, “AI-Enabled Human Memory Manipulation” (arXiv:2609.28820)、Axon “Axon Reimagines Report Writing With Draft One” (Officer.com掲載)

    関連記事

    あわせて読みたい: AIに判断や記憶を任せると何が起きるかは認知オフローディングとは?3分でわかる仕組みと注意点で解説しています。