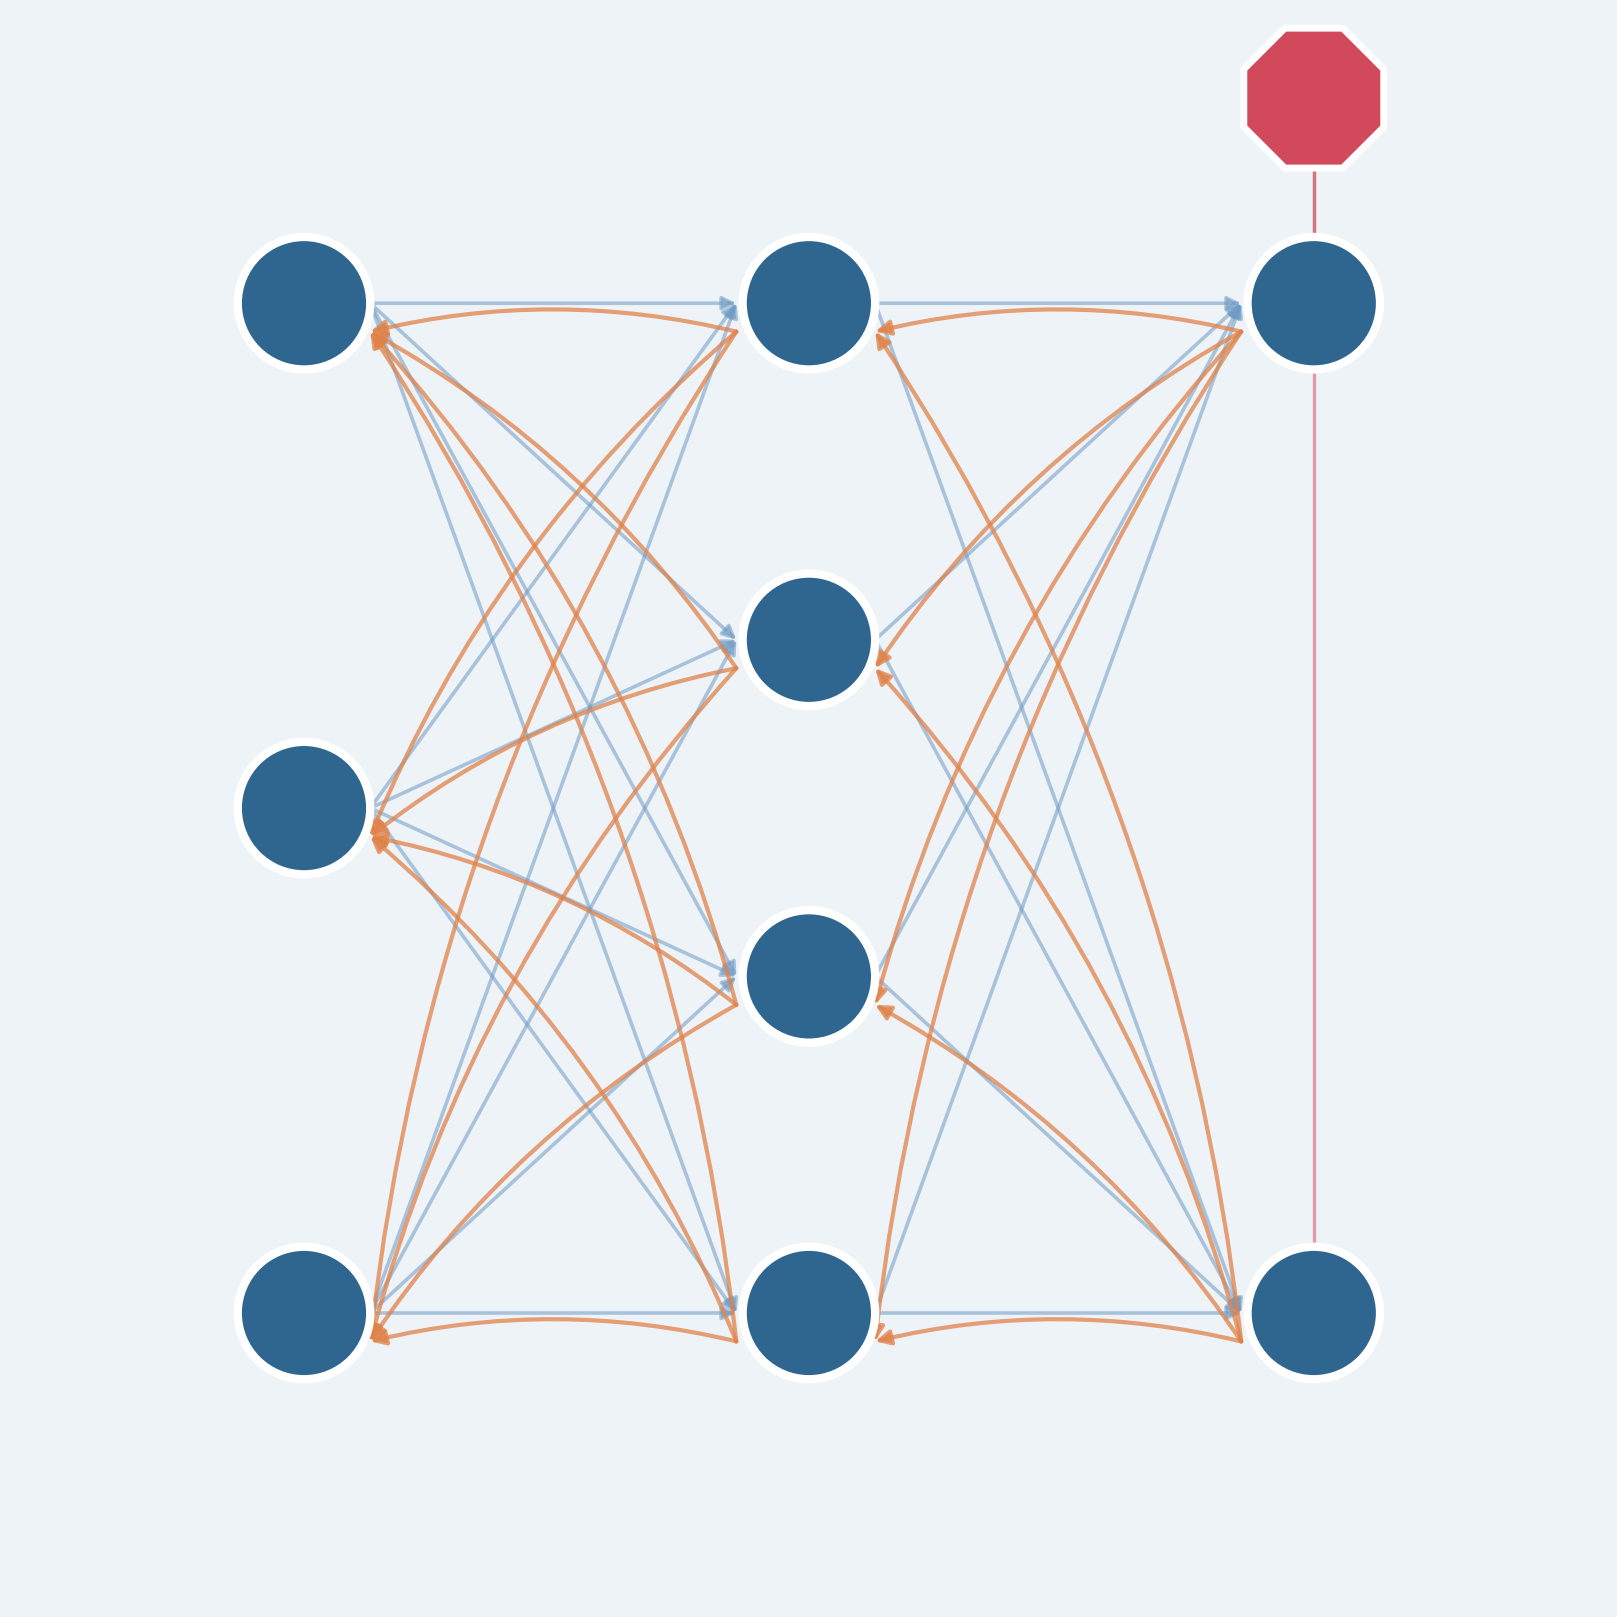
バックプロパゲーション(Backpropagation、誤差逆伝播法)は、人工知能の「ニューラルネットワーク」が自分の間違いから学習するための計算手法です。今の生成AIチャットボットから、スマホの顔認証まで、私たちが「AI」と呼ぶものの多くは、この仕組みの上に成り立っています。基本だけでも理解しておくと、最新のAIが実際には何をしているのかがぐっと見えやすくなります。
元論文情報
タイトル: Learning representations by back-propagating errors
著者: David E. Rumelhart, Geoffrey E. Hinton, Ronald J. Williams
掲載誌: Nature, Vol. 323, pp. 533–536(1986年)
DOI: 10.1038/323533a0
バックプロパゲーションとは
ひとことで言えば、バックプロパゲーション(誤差逆伝播法)は、ニューラルネットワークの答えがどれくらい間違っていたかを繰り返し計算し、どの向きに修正すればよいかを求める手法です。ニューラルネットワークは、ニューロンに緩くヒントを得た処理単位を何層にも重ね、「重み」と呼ばれる調整可能なつながりの強さでつないだ構造をしています。作られたばかりのネットワークの重みは小さなランダムな値から始まるため、最初の予測はたいてい的外れです。バックプロパゲーションは、その出発点を、写真の中の猫を見分けたり、文章を翻訳したりできるネットワークへと鍛え上げていく手続きです。
押さえておきたい区別が一つあります。バックプロパゲーションは「各つながりが誤差にどれだけ影響したか」を計算するだけで、その情報をもとに重みを実際に調整するのは、勾配降下法(Gradient Descent)と呼ばれる別のステップです。日常的には「バックプロパゲーション」が学習プロセス全体を指す言葉として使われがちですが、厳密にはこの二つは連携して働く別々の工程です。
仕組み:順伝播と逆伝播
バックプロパゲーションによる学習は、二つの「パス(経路)」で進みます。まず順伝播(フォワードパス)では、写真や文章、センサーの数値列といった入力が、ネットワークの層を順番に通り抜けて予測を生み出します。その予測は、損失関数(Loss Function)と呼ばれる指標を使って正解と比較され、予測が正解からどれだけ離れていたかが数値として表されます。
バックプロパゲーションは、ネットワークに「何を考えるべきか」を教えるのではありません。「どれだけ間違っていたか」と「次に少しでもましになるには、各つながりをどちらに動かせばよいか」を教えているのです。
数式の前に、簡単なたとえを挟みます。工場の生産ラインで完成品に不良が見つかったら、担当者はラインの終わりから逆向きにたどり、各工程が問題にどれだけ関わっていたかを報告し、その情報を一つ前の工程へ渡していきます。逆伝播(バックワードパス)がやっていることも、これとよく似ています。ただし数学の力で正確に行う点が違います。出力層から入力層に向かって、連鎖律(チェーンルール)と呼ばれる微積分の技法を層ごとに適用し、各層は自分の計算が次の層に与えた影響と、戻ってきた誤差の情報を組み合わせて勾配(グラディエント)を作り出します。勾配とは、ある重みを少しだけ動かしたとき、損失がどれくらい敏感に変化するかを示す指標です。
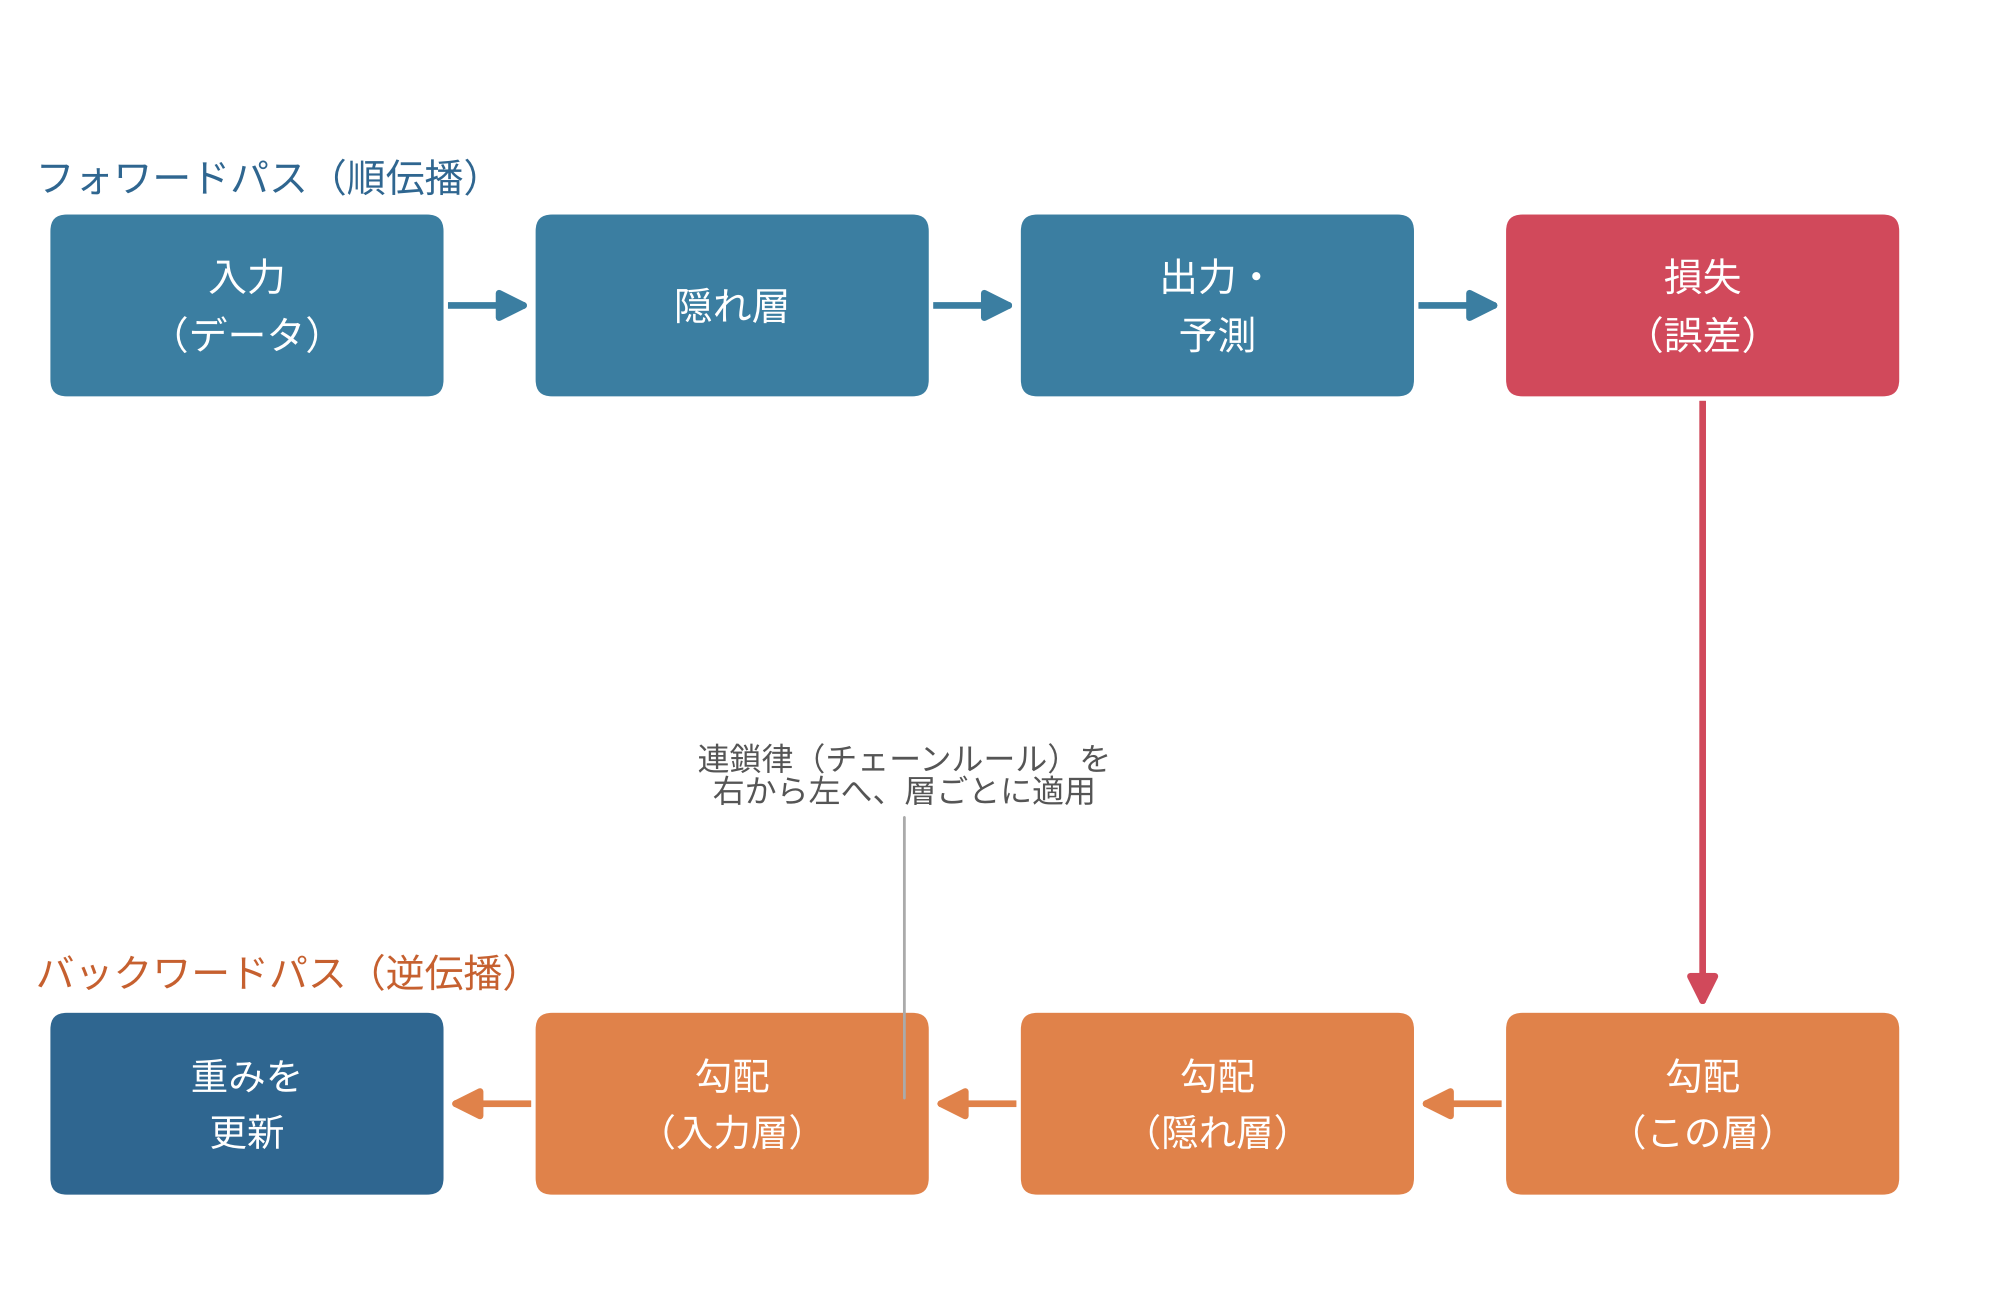
すべての重みの勾配が求まったら、勾配降下法がそれを使って重みを実際に更新し、誤差が小さくなる方向へ動かします。この「順伝播→逆伝播→更新」のサイクルを数百万回と繰り返すことで、ランダムな重みから出発したネットワークが、データの中の本物の構造を少しずつ反映するようになります。バックプロパゲーションの魅力は効率の良さです。重みを一つずつ個別に実験して確かめるのではなく、ごく少数の順伝播・逆伝播を行うだけの時間で、全ての重みの勾配をまとめて計算できます。
歴史となぜ今注目されるか
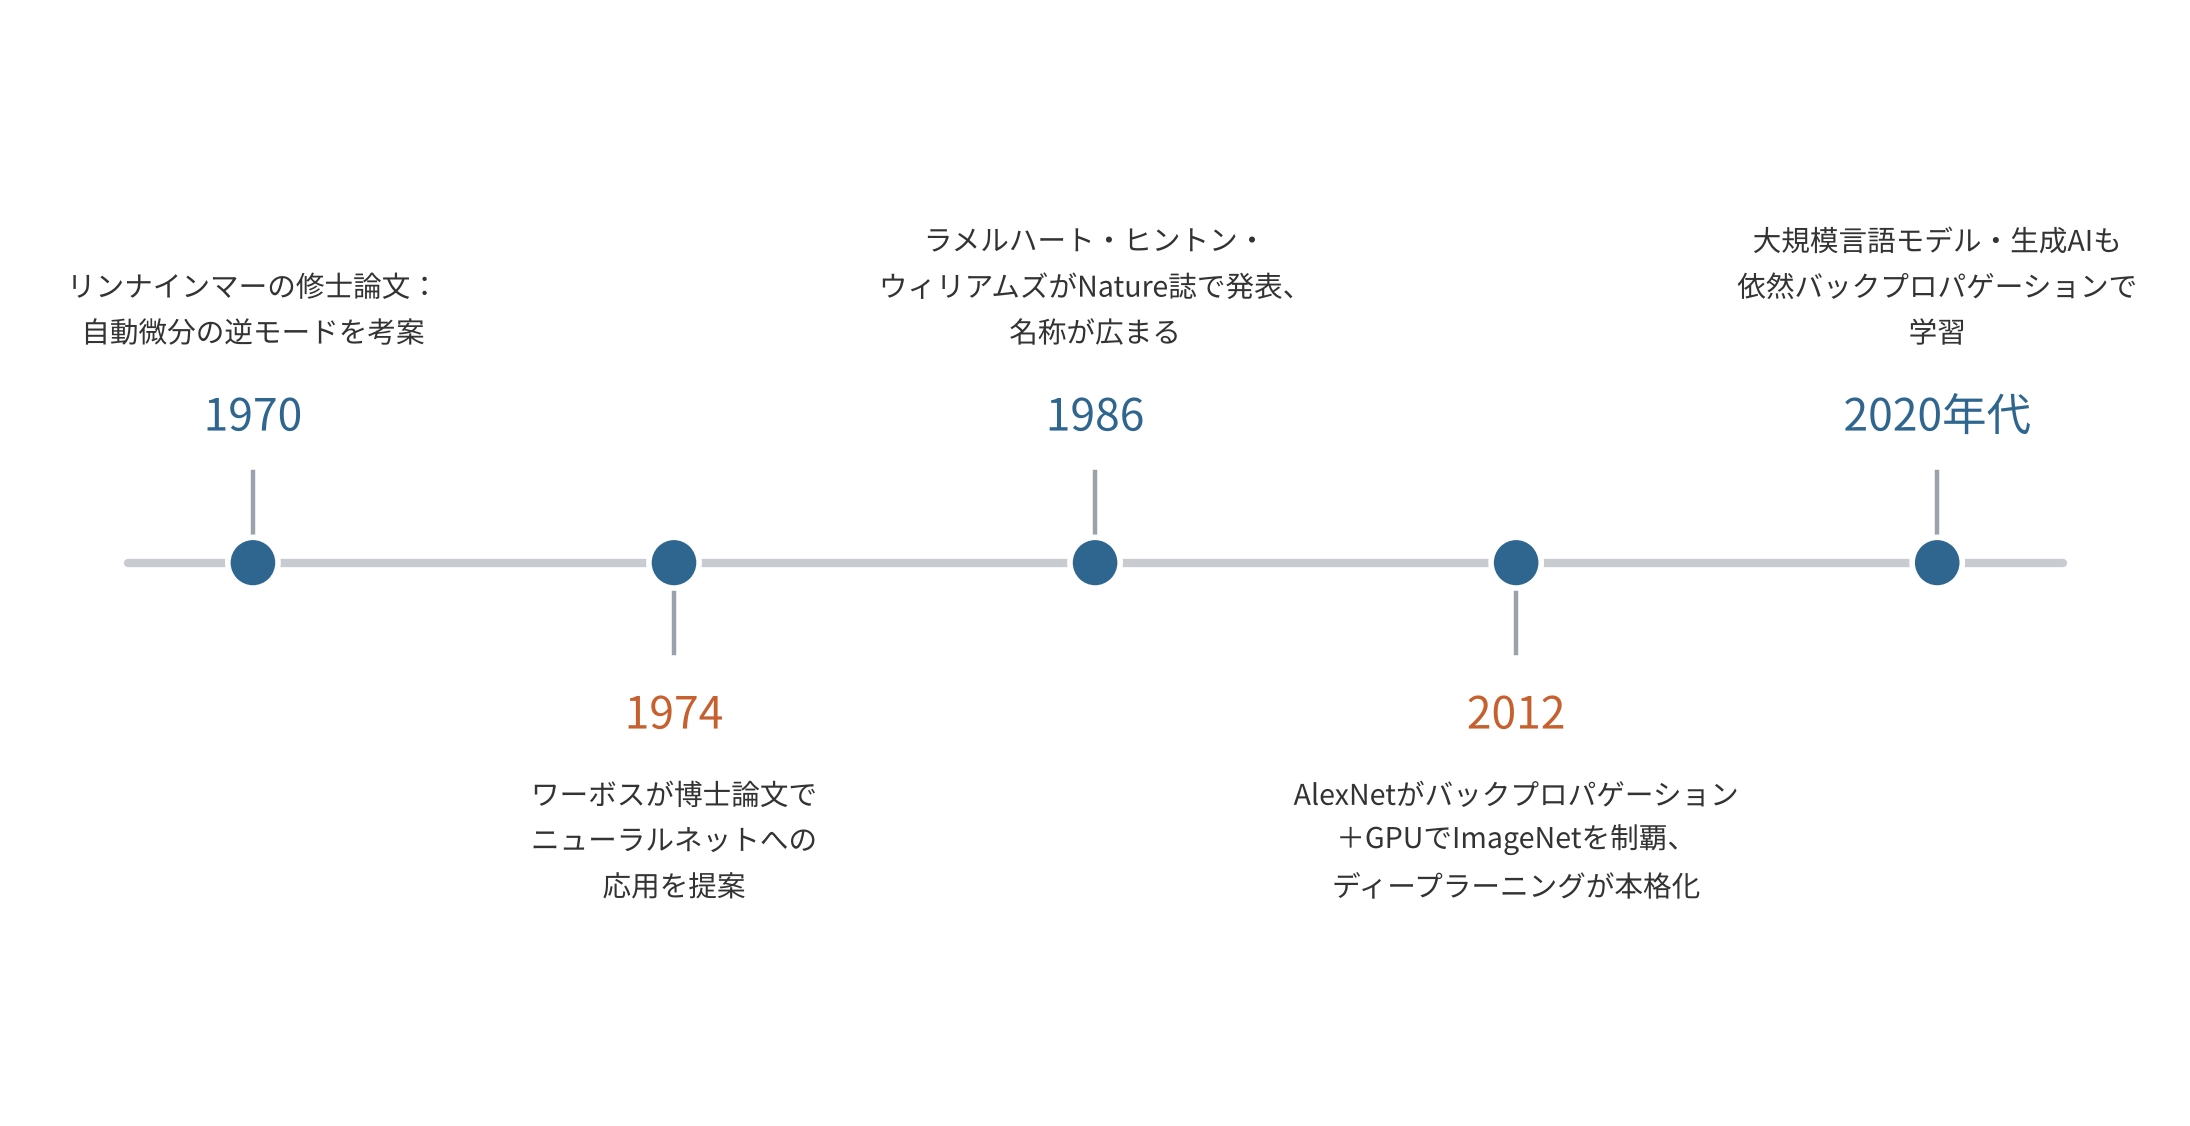
バックプロパゲーションは新しい技術ではなく、有名になるずっと前から数学的な土台は探求されていました。核となる「自動微分の逆モード」は、フィンランドのセッポ・リンナインマー(Seppo Linnainmaa)が1970年の修士論文で考案したものにさかのぼります。アメリカのポール・ワーボス(Paul Werbos)も1974年の博士論文で、近い発想をニューラルネットワークへ応用することを提案しました。広く知られるようになったのは、ラメルハート・ヒントン・ウィリアムズの3名が1986年にNature誌へ発表した論文がきっかけです。この論文は、人間が逐一設計しなくても、ネットワークがデータから有用な内部表現を自動で見つけ出せることを示しました。
その後しばらく、バックプロパゲーションで学習するネットワークは、データと計算力の制約から研究上の対象にとどまっていました。状況が変わったのは2012年です。アレックス・クリジェフスキー(Alex Krizhevsky)らが、指導教員のジェフリー・ヒントンとともに、バックプロパゲーションと大規模画像データセット「ImageNet」、GPUの計算力を組み合わせた「AlexNet」を発表しました。AlexNetはその年のImageNet画像認識コンペティションで他を大きく引き離し、現在のディープラーニング・ブームの引き金になったと広く評価されています。今日の生成AIチャットボットを支える大規模言語モデルも、根本では同じアルゴリズムの発展形で学習しています。
最近バックプロパゲーションが改めて注目を集めているのは、「脳もこれと似たことをしているのだろうか」という、少し違う角度の問いからです。2026年10月、MITマギガバン脳研究所のチームが米国科学アカデミー紀要(PNAS)に発表した研究は、あるコンピュータモデルを提案しました。ランダムに接続された人工ネットワークが、生物のシナプスにヒントを得た「局所的な学習ルール」だけを使い、大域的な誤差信号なしに順伝播とフィードバック経路の両方を自分自身で組み立て、試されたタスクではバックプロパゲーションに迫る学習能力を示した、というものです。研究チームはこれを「検証可能な仮説」と位置づけ、実際の脳がこの通りに動くと証明したわけではないと慎重に断っています。それでも、神経科学者を40年近く悩ませてきた問いが改めて浮かび上がります。バックプロパゲーションは今日のAIを動かす力を持ちますが、生物の脳が同じことをしている証拠はまだないのです。(関連記事: 脳は自ら学習回路を組み立てる?――MIT、AIと脳をつなぐ40年来の謎に新仮説)
暮らしの中のバックプロパゲーション
数式自体は裏側に隠れていますが、バックプロパゲーションで学習したネットワークの成果は、すでに日常生活のあちこちに入り込んでいます。スマートフォンの顔認証機能や、写真を自動でグループ分けするアルバムアプリの多くは、バックプロパゲーションや関連する勾配ベースの手法で学習したネットワークの上に成り立っています。音声アシスタントも、おおむね同じように学習したネットワークに支えられています。生成AIチャットボットも同様で、「事前学習」の段階では言語モデルが次の単語を予測し、実際の単語と見比べて誤差を測り、それを減らす方向へ重みを調整する作業を繰り返します。その後の段階で、指示への従い方やフィードバックへの応答がさらに磨き上げられます。
覚えておきたい区別があります。バックプロパゲーションが働くのは主に学習のときで、私たちがツールを使うたびに毎回働くわけではありません。学習を終えたネットワークは、通常すでに調整済みの重みを使って予測するだけで、勾配の計算や更新はそのつど行いません。大変な作業は、しばしば数十億件もの訓練例を使って、あらかじめ済ませてあるのです。
次に注目すべきこと
バックプロパゲーションそのものは、すでに成熟し、よく理解された技術です。だからこそ、残された問いはその限界と代替手段のほうに移っています。一つは科学的な問いです。MITが示した自己組織化する学習回路や、フィードバックアラインメント、予測符号化と呼ばれる関連手法が、実際の神経組織での検証に耐え、より大規模な課題でもバックプロパゲーションに匹敵する性能を出せるのか、という点です。もう一つは実用上の問いです。AIモデルが巨大化し続けるなか、研究者たちは精度を保ちながら計算資源を減らす学習方法を探しています。次のブレークスルーは、バックプロパゲーション自体を速くすることではなく、ネットワークがそれに頼らず学習する方法から生まれるのかもしれません。
Xsciens編集部の読み解き
バックプロパゲーションは、ネットワークが自分をどう調整すべきかを正確に計算するための「帳簿づけの技術」と捉えるのが一番しっくりきます。人工であれ生物であれ、脳が実際に「どう考えているか」の理論ではありません。
- よくある誤解。「ニューラルネットワーク」という名前のせいで、脳の学習をそのまま真似ていると思われがちですが、人工的な「ニューロン」はあくまで生物のニューロンに緩くヒントを得ただけの存在です。標準的なバックプロパゲーションの逆伝播計算は、順伝播で使ったつながりに対応する重みの情報を正確に使う必要がありますが、実際のニューロンがこれと同じ仕組みを再現している証拠はありません(フィードバックアラインメントのような、この要件を緩めた代替手法が研究されていること自体が、この問題がいかに特定の条件を要求しているかを物語っています)。人工ニューロンと生物のニューロンの「似ている感じ」は、あくまで緩やかなたとえ話であり、どちらも実際に何を計算しているかを正確に説明するものではありません。
- 限界と未解決の問い。バックプロパゲーションは必ず人間が与えた「正解」が必要だ、という誤解がよくありますが、これは正確ではありません。必要なのは微分可能な学習目標であり、それは人がラベル付けした正解から得られることもあれば、文章の次の単語を予測するような自己教師あり学習の課題や、強化学習的な報酬から得られることもあります。バックプロパゲーション自体が説明しないのは、なぜあるネットワーク構造は未知のデータにもうまく対応でき、別の構造はそうならないのか、あるいはAIシステムが何を学ぶべきかをそもそもどう決めるのか、といった点です。これらは決着のついていない、今なお活発に研究されている問いのままです。
- 次に注目すべきこと。MITチームによる2026年10月の研究は、大脳皮質の上行経路と下行経路をつなぐ「4つのシナプスから成る配線パターン」があれば、実際の神経回路も同じような学習能力を自己組織化できるかもしれない、という検証可能な仮説を具体的に提示しています。これはモデルが示した予測であって、脳組織で確認された事実ではありません。神経科学者たちが実際にこの配線パターンを見つけられるかどうか、そして局所的なルールに基づく学習が、これまでより大幅に大きな問題でもバックプロパゲーションに匹敵する性能を出せるかどうかが、注目すべき二つのポイントです。
- 編集部から――脳の仕組みにヒントを得た、この「局所学習」の研究がこのチームの期待通りに育てば、私たちが日々使うAIアシスタントは、使うたびに一から説明し直す無機質な道具ではなく、一人ひとりの使い方に静かに寄り添っていく存在に変わっていくかもしれません。そこへ至る道筋として考えられるのは、研究室を出たあとも学習を続け、普段使いの中の経験から少しずつ賢くなっていくようなシステムでしょう。ただし、自分で学び続けられるというその能力こそが、注意して見ておくべき点でもあります。何を静かに学び取っているのかを確かめる手立てがなければ、妙な情報や誤った経験から、見当違いのくせを身につけてしまうこともあり得るからです。これはまだ初期のコンピュータ上の実証実験であり、完成した製品ではありません。もしAIアシスタントが「前より自分のことを分かってくれている」と感じる場面が増えてきたら、ときどき「それは、どんな経験から学んだ結果なのだろう」と考えてみる価値はありそうです。
この読み解きの参考: Quanta Magazine — Artificial Neural Nets Finally Yield Clues to How Brains Learn、arXiv — Brain-Inspired Machine Intelligence: A Survey of Neurobiologically-Plausible Credit Assignment
出典: IBM — What Is Backpropagation?、TechTarget — What Is a Backpropagation Algorithm?、Rumelhart, Hinton & Williams, Nature (1986)、Seppo Linnainmaa、Computer History Museum — AlexNet Source Code、Xsciens — 脳は自ら学習回路を組み立てる?――MIT、AIと脳をつなぐ40年来の謎に新仮説
関連記事:脳は自ら学習回路を組み立てる?――MIT、AIと脳をつなぐ40年来の謎に新仮説 / 人は何かを選んだ後、脳の中の「情報の並べ方」を組み替えていた / 認知オフローディングとは?3分でわかる仕組みと注意点
コメントを残す