タグ: 用語解説

  • 【科学】バックプロパゲーションとは?3分でわかる仕組みと将来性

    【科学】バックプロパゲーションとは?3分でわかる仕組みと将来性

    バックプロパゲーション(Backpropagation、誤差逆伝播法)は、人工知能の「ニューラルネットワーク」が自分の間違いから学習するための計算手法です。今の生成AIチャットボットから、スマホの顔認証まで、私たちが「AI」と呼ぶものの多くは、この仕組みの上に成り立っています。基本だけでも理解しておくと、最新のAIが実際には何をしているのかがぐっと見えやすくなります。

    元論文情報

    タイトル: Learning representations by back-propagating errors
    著者: David E. Rumelhart, Geoffrey E. Hinton, Ronald J. Williams
    掲載誌: Nature, Vol. 323, pp. 533–536(1986年)
    DOI: 10.1038/323533a0

    バックプロパゲーションとは

    ひとことで言えば、バックプロパゲーション(誤差逆伝播法)は、ニューラルネットワークの答えがどれくらい間違っていたかを繰り返し計算し、どの向きに修正すればよいかを求める手法です。ニューラルネットワークは、ニューロンに緩くヒントを得た処理単位を何層にも重ね、「重み」と呼ばれる調整可能なつながりの強さでつないだ構造をしています。作られたばかりのネットワークの重みは小さなランダムな値から始まるため、最初の予測はたいてい的外れです。バックプロパゲーションは、その出発点を、写真の中の猫を見分けたり、文章を翻訳したりできるネットワークへと鍛え上げていく手続きです。

    押さえておきたい区別が一つあります。バックプロパゲーションは「各つながりが誤差にどれだけ影響したか」を計算するだけで、その情報をもとに重みを実際に調整するのは、勾配降下法(Gradient Descent)と呼ばれる別のステップです。日常的には「バックプロパゲーション」が学習プロセス全体を指す言葉として使われがちですが、厳密にはこの二つは連携して働く別々の工程です。

    仕組み:順伝播と逆伝播

    バックプロパゲーションによる学習は、二つの「パス(経路)」で進みます。まず順伝播(フォワードパス)では、写真や文章、センサーの数値列といった入力が、ネットワークの層を順番に通り抜けて予測を生み出します。その予測は、損失関数(Loss Function)と呼ばれる指標を使って正解と比較され、予測が正解からどれだけ離れていたかが数値として表されます。

    バックプロパゲーションは、ネットワークに「何を考えるべきか」を教えるのではありません。「どれだけ間違っていたか」と「次に少しでもましになるには、各つながりをどちらに動かせばよいか」を教えているのです。

    数式の前に、簡単なたとえを挟みます。工場の生産ラインで完成品に不良が見つかったら、担当者はラインの終わりから逆向きにたどり、各工程が問題にどれだけ関わっていたかを報告し、その情報を一つ前の工程へ渡していきます。逆伝播(バックワードパス)がやっていることも、これとよく似ています。ただし数学の力で正確に行う点が違います。出力層から入力層に向かって、連鎖律(チェーンルール)と呼ばれる微積分の技法を層ごとに適用し、各層は自分の計算が次の層に与えた影響と、戻ってきた誤差の情報を組み合わせて勾配(グラディエント)を作り出します。勾配とは、ある重みを少しだけ動かしたとき、損失がどれくらい敏感に変化するかを示す指標です。
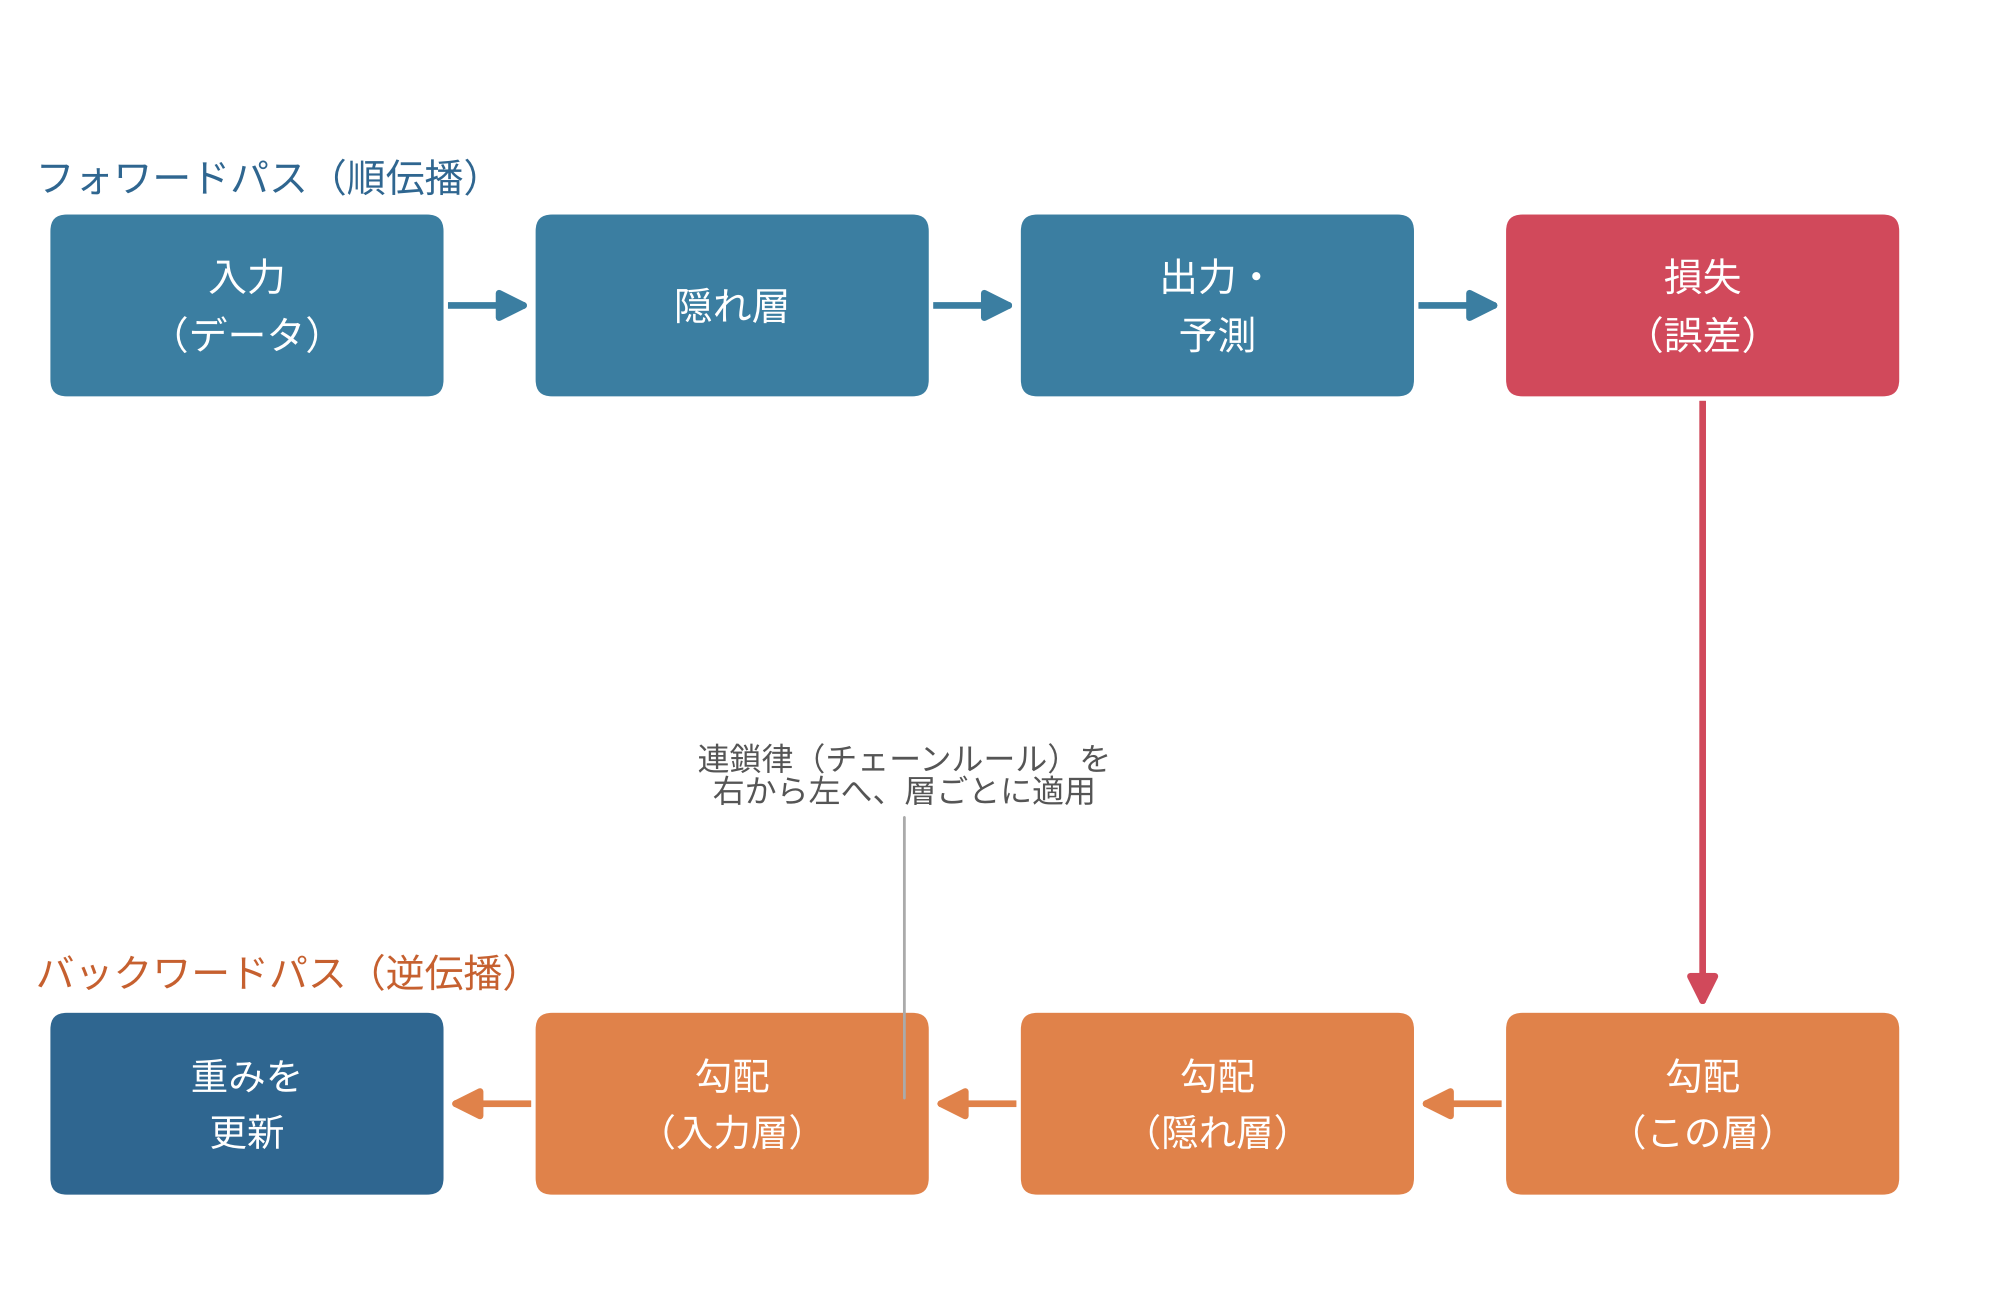
    バックプロパゲーションにおける順伝播と逆伝播の流れを示す図
    順伝播で予測と損失が計算され、逆伝播では連鎖律を使って層ごとに勾配を求め、重みを更新する。

    すべての重みの勾配が求まったら、勾配降下法がそれを使って重みを実際に更新し、誤差が小さくなる方向へ動かします。この「順伝播→逆伝播→更新」のサイクルを数百万回と繰り返すことで、ランダムな重みから出発したネットワークが、データの中の本物の構造を少しずつ反映するようになります。バックプロパゲーションの魅力は効率の良さです。重みを一つずつ個別に実験して確かめるのではなく、ごく少数の順伝播・逆伝播を行うだけの時間で、全ての重みの勾配をまとめて計算できます。

    歴史となぜ今注目されるか

    バックプロパゲーションは新しい技術ではなく、有名になるずっと前から数学的な土台は探求されていました。核となる「自動微分の逆モード」は、フィンランドのセッポ・リンナインマー(Seppo Linnainmaa)が1970年の修士論文で考案したものにさかのぼります。アメリカのポール・ワーボス(Paul Werbos)も1974年の博士論文で、近い発想をニューラルネットワークへ応用することを提案しました。広く知られるようになったのは、ラメルハート・ヒントン・ウィリアムズの3名が1986年にNature誌へ発表した論文がきっかけです。この論文は、人間が逐一設計しなくても、ネットワークがデータから有用な内部表現を自動で見つけ出せることを示しました。

    その後しばらく、バックプロパゲーションで学習するネットワークは、データと計算力の制約から研究上の対象にとどまっていました。状況が変わったのは2012年です。アレックス・クリジェフスキー(Alex Krizhevsky)らが、指導教員のジェフリー・ヒントンとともに、バックプロパゲーションと大規模画像データセット「ImageNet」、GPUの計算力を組み合わせた「AlexNet」を発表しました。AlexNetはその年のImageNet画像認識コンペティションで他を大きく引き離し、現在のディープラーニング・ブームの引き金になったと広く評価されています。今日の生成AIチャットボットを支える大規模言語モデルも、根本では同じアルゴリズムの発展形で学習しています。
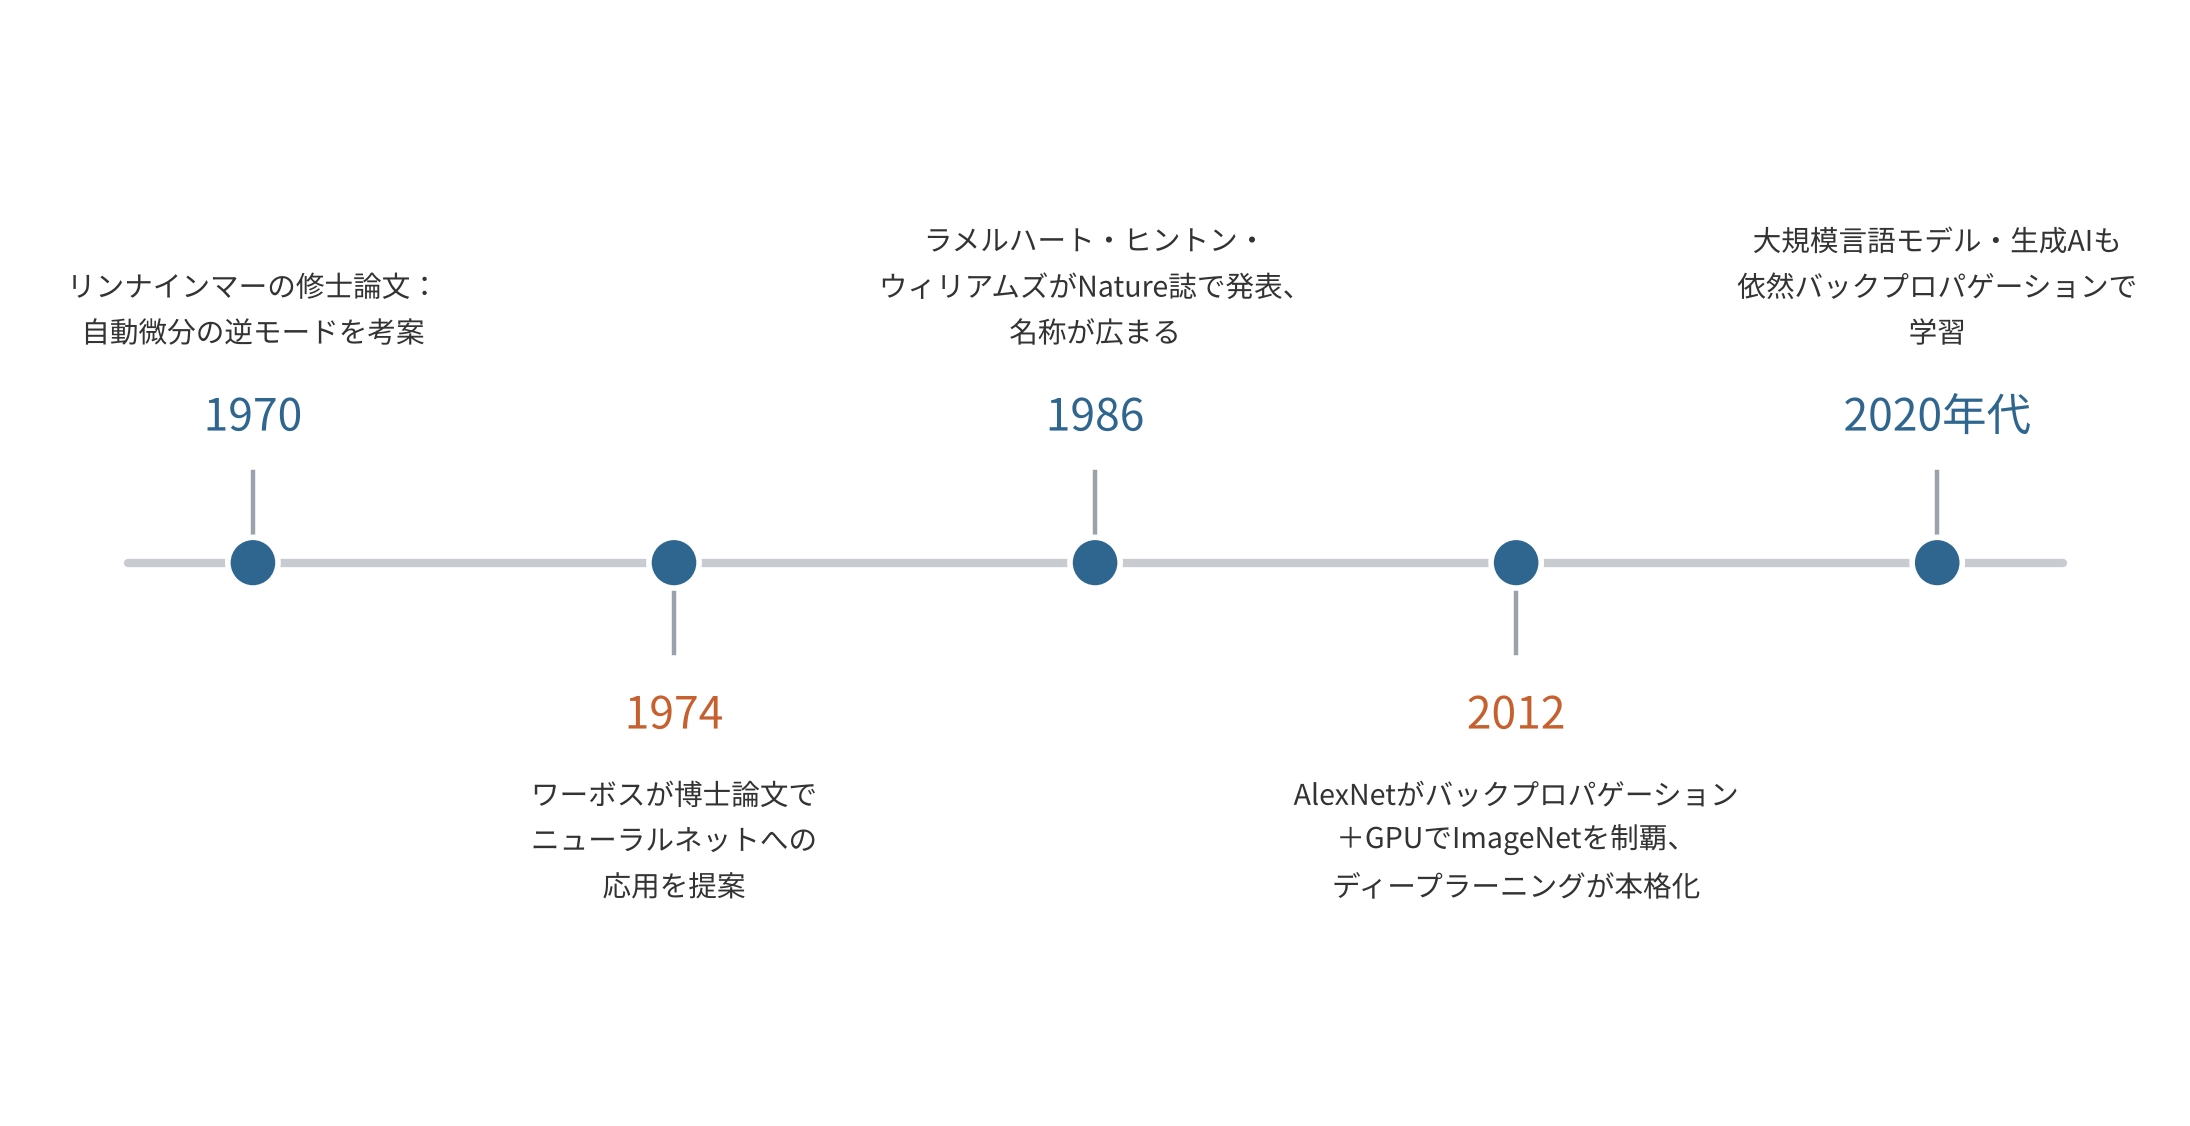
    バックプロパゲーションの歴史を示す年表(1970年から2020年代まで)
    出典: リンナインマー(1970年)、ワーボス(1974年)、ラメルハート・ヒントン・ウィリアムズのNature論文(1986年)、AlexNet/ImageNetの成果(2012年)をもとに作成。

    最近バックプロパゲーションが改めて注目を集めているのは、「脳もこれと似たことをしているのだろうか」という、少し違う角度の問いからです。2026年10月、MITマギガバン脳研究所のチームが米国科学アカデミー紀要(PNAS)に発表した研究は、あるコンピュータモデルを提案しました。ランダムに接続された人工ネットワークが、生物のシナプスにヒントを得た「局所的な学習ルール」だけを使い、大域的な誤差信号なしに順伝播とフィードバック経路の両方を自分自身で組み立て、試されたタスクではバックプロパゲーションに迫る学習能力を示した、というものです。研究チームはこれを「検証可能な仮説」と位置づけ、実際の脳がこの通りに動くと証明したわけではないと慎重に断っています。それでも、神経科学者を40年近く悩ませてきた問いが改めて浮かび上がります。バックプロパゲーションは今日のAIを動かす力を持ちますが、生物の脳が同じことをしている証拠はまだないのです。(関連記事: 脳は自ら学習回路を組み立てる?――MIT、AIと脳をつなぐ40年来の謎に新仮説)

    暮らしの中のバックプロパゲーション

    数式自体は裏側に隠れていますが、バックプロパゲーションで学習したネットワークの成果は、すでに日常生活のあちこちに入り込んでいます。スマートフォンの顔認証機能や、写真を自動でグループ分けするアルバムアプリの多くは、バックプロパゲーションや関連する勾配ベースの手法で学習したネットワークの上に成り立っています。音声アシスタントも、おおむね同じように学習したネットワークに支えられています。生成AIチャットボットも同様で、「事前学習」の段階では言語モデルが次の単語を予測し、実際の単語と見比べて誤差を測り、それを減らす方向へ重みを調整する作業を繰り返します。その後の段階で、指示への従い方やフィードバックへの応答がさらに磨き上げられます。

    覚えておきたい区別があります。バックプロパゲーションが働くのは主に学習のときで、私たちがツールを使うたびに毎回働くわけではありません。学習を終えたネットワークは、通常すでに調整済みの重みを使って予測するだけで、勾配の計算や更新はそのつど行いません。大変な作業は、しばしば数十億件もの訓練例を使って、あらかじめ済ませてあるのです。

    次に注目すべきこと

    バックプロパゲーションそのものは、すでに成熟し、よく理解された技術です。だからこそ、残された問いはその限界と代替手段のほうに移っています。一つは科学的な問いです。MITが示した自己組織化する学習回路や、フィードバックアラインメント、予測符号化と呼ばれる関連手法が、実際の神経組織での検証に耐え、より大規模な課題でもバックプロパゲーションに匹敵する性能を出せるのか、という点です。もう一つは実用上の問いです。AIモデルが巨大化し続けるなか、研究者たちは精度を保ちながら計算資源を減らす学習方法を探しています。次のブレークスルーは、バックプロパゲーション自体を速くすることではなく、ネットワークがそれに頼らず学習する方法から生まれるのかもしれません。

    Xsciens編集部の読み解き

    バックプロパゲーションは、ネットワークが自分をどう調整すべきかを正確に計算するための「帳簿づけの技術」と捉えるのが一番しっくりきます。人工であれ生物であれ、脳が実際に「どう考えているか」の理論ではありません。

    • よくある誤解。「ニューラルネットワーク」という名前のせいで、脳の学習をそのまま真似ていると思われがちですが、人工的な「ニューロン」はあくまで生物のニューロンに緩くヒントを得ただけの存在です。標準的なバックプロパゲーションの逆伝播計算は、順伝播で使ったつながりに対応する重みの情報を正確に使う必要がありますが、実際のニューロンがこれと同じ仕組みを再現している証拠はありません(フィードバックアラインメントのような、この要件を緩めた代替手法が研究されていること自体が、この問題がいかに特定の条件を要求しているかを物語っています)。人工ニューロンと生物のニューロンの「似ている感じ」は、あくまで緩やかなたとえ話であり、どちらも実際に何を計算しているかを正確に説明するものではありません。
    • 限界と未解決の問い。バックプロパゲーションは必ず人間が与えた「正解」が必要だ、という誤解がよくありますが、これは正確ではありません。必要なのは微分可能な学習目標であり、それは人がラベル付けした正解から得られることもあれば、文章の次の単語を予測するような自己教師あり学習の課題や、強化学習的な報酬から得られることもあります。バックプロパゲーション自体が説明しないのは、なぜあるネットワーク構造は未知のデータにもうまく対応でき、別の構造はそうならないのか、あるいはAIシステムが何を学ぶべきかをそもそもどう決めるのか、といった点です。これらは決着のついていない、今なお活発に研究されている問いのままです。
    • 次に注目すべきこと。MITチームによる2026年10月の研究は、大脳皮質の上行経路と下行経路をつなぐ「4つのシナプスから成る配線パターン」があれば、実際の神経回路も同じような学習能力を自己組織化できるかもしれない、という検証可能な仮説を具体的に提示しています。これはモデルが示した予測であって、脳組織で確認された事実ではありません。神経科学者たちが実際にこの配線パターンを見つけられるかどうか、そして局所的なルールに基づく学習が、これまでより大幅に大きな問題でもバックプロパゲーションに匹敵する性能を出せるかどうかが、注目すべき二つのポイントです。
    • 編集部から――脳の仕組みにヒントを得た、この「局所学習」の研究がこのチームの期待通りに育てば、私たちが日々使うAIアシスタントは、使うたびに一から説明し直す無機質な道具ではなく、一人ひとりの使い方に静かに寄り添っていく存在に変わっていくかもしれません。そこへ至る道筋として考えられるのは、研究室を出たあとも学習を続け、普段使いの中の経験から少しずつ賢くなっていくようなシステムでしょう。ただし、自分で学び続けられるというその能力こそが、注意して見ておくべき点でもあります。何を静かに学び取っているのかを確かめる手立てがなければ、妙な情報や誤った経験から、見当違いのくせを身につけてしまうこともあり得るからです。これはまだ初期のコンピュータ上の実証実験であり、完成した製品ではありません。もしAIアシスタントが「前より自分のことを分かってくれている」と感じる場面が増えてきたら、ときどき「それは、どんな経験から学んだ結果なのだろう」と考えてみる価値はありそうです。

    この読み解きの参考: Quanta Magazine — Artificial Neural Nets Finally Yield Clues to How Brains Learn、arXiv — Brain-Inspired Machine Intelligence: A Survey of Neurobiologically-Plausible Credit Assignment

    出典: IBM — What Is Backpropagation?、TechTarget — What Is a Backpropagation Algorithm?、Rumelhart, Hinton & Williams, Nature (1986)、Seppo Linnainmaa、Computer History Museum — AlexNet Source Code、Xsciens — 脳は自ら学習回路を組み立てる?――MIT、AIと脳をつなぐ40年来の謎に新仮説

    関連記事:脳は自ら学習回路を組み立てる?――MIT、AIと脳をつなぐ40年来の謎に新仮説 / 人は何かを選んだ後、脳の中の「情報の並べ方」を組み替えていた / 認知オフローディングとは?3分でわかる仕組みと注意点
  • 【科学】超分子ポリマーとは?3分でわかる仕組みと将来性

    【科学】超分子ポリマーとは?3分でわかる仕組みと将来性

    超分子ポリマー(Supramolecular Polymer)とは、強く固定された化学結合ではなく、弱く可逆的な結びつきで部品同士がつながった、鎖のような材料のことです。この「弱いけれど数が多い」設計のおかげで、傷を自ら修復したり、形を変えたり、生きた細胞の振る舞いに影響を与えたりできます。だからこそ材料科学者たちは、より大きく精密に制御された超分子ポリマーの開発を競っています。

    超分子ポリマーとは何か

    ペットボトルのプラスチックのような普通の高分子(ポリマー)は、モノマーと呼ばれる小さな繰り返し単位が、共有結合によって端から端まで溶接のようにつながった長い鎖です。共有結合は電子を共有して結びつく強い化学結合で、一度できるとそう簡単には切れません。

    超分子ポリマーは、この永続的な「溶接」を一時的な「握手」に置き換えたものです。部品となる分子同士は、水素結合、芳香環が重なり合うスタッキング、金属イオンを介した架橋、電気的な引力といった非共有結合でつながります。一つひとつは弱くても、鎖に沿って何千個と連なることで、安定して機能する材料になります。身近な例では面ファスナー(マジックテープ)が近く、フックとループの組は一つだけならすぐ剥がれますが、たくさん並べば厚手のジャケットもしっかり留められます。超分子ポリマーも分子のスケールで同じことが起き、弱い結合が大量に集まることで強くてなお可逆的な材料として振る舞います。

    IUPAC(国際純正・応用化学連合)が2013年に示した用語推奨では、この自己組織化の過程そのものに「超分子会合(レーン会合)」という呼び方が好まれ、「超分子重合」という表現は推奨されていません。ただしこれは現象の呼び方の話であり、材料の呼び名を否定するものではなく、2026年のノースウェスタン大学の論文タイトルにも使われているとおり「超分子ポリマー」という呼称は今も広く使われているため、本記事でもこの一般的な意味で用います。

    自己組織化の仕組み

    超分子ポリマーの結合は可逆的なので、個々の結びつきは絶えず切れたりつながり直したりしています。これにより材料は周囲の状況に応じて自らを調整でき、必ずしもバラバラに崩れるわけではありません。破損部分の表面同士が再び接触でき分子が十分動ける状態であれば、可逆的な結びつきが損傷箇所をまたいでつなぎ直されることがあり、これが一部(すべてではありません)の超分子材料に見られる自己修復の仕組みです。米国プラスチック技術者協会(SPE)の2024年の概説によれば、同じ動的な結合のおかげで一部の超分子ポリマーは通常のプラスチックより加工しやすい場合がありますが、必要な温度や圧力は分子設計によって変わります。

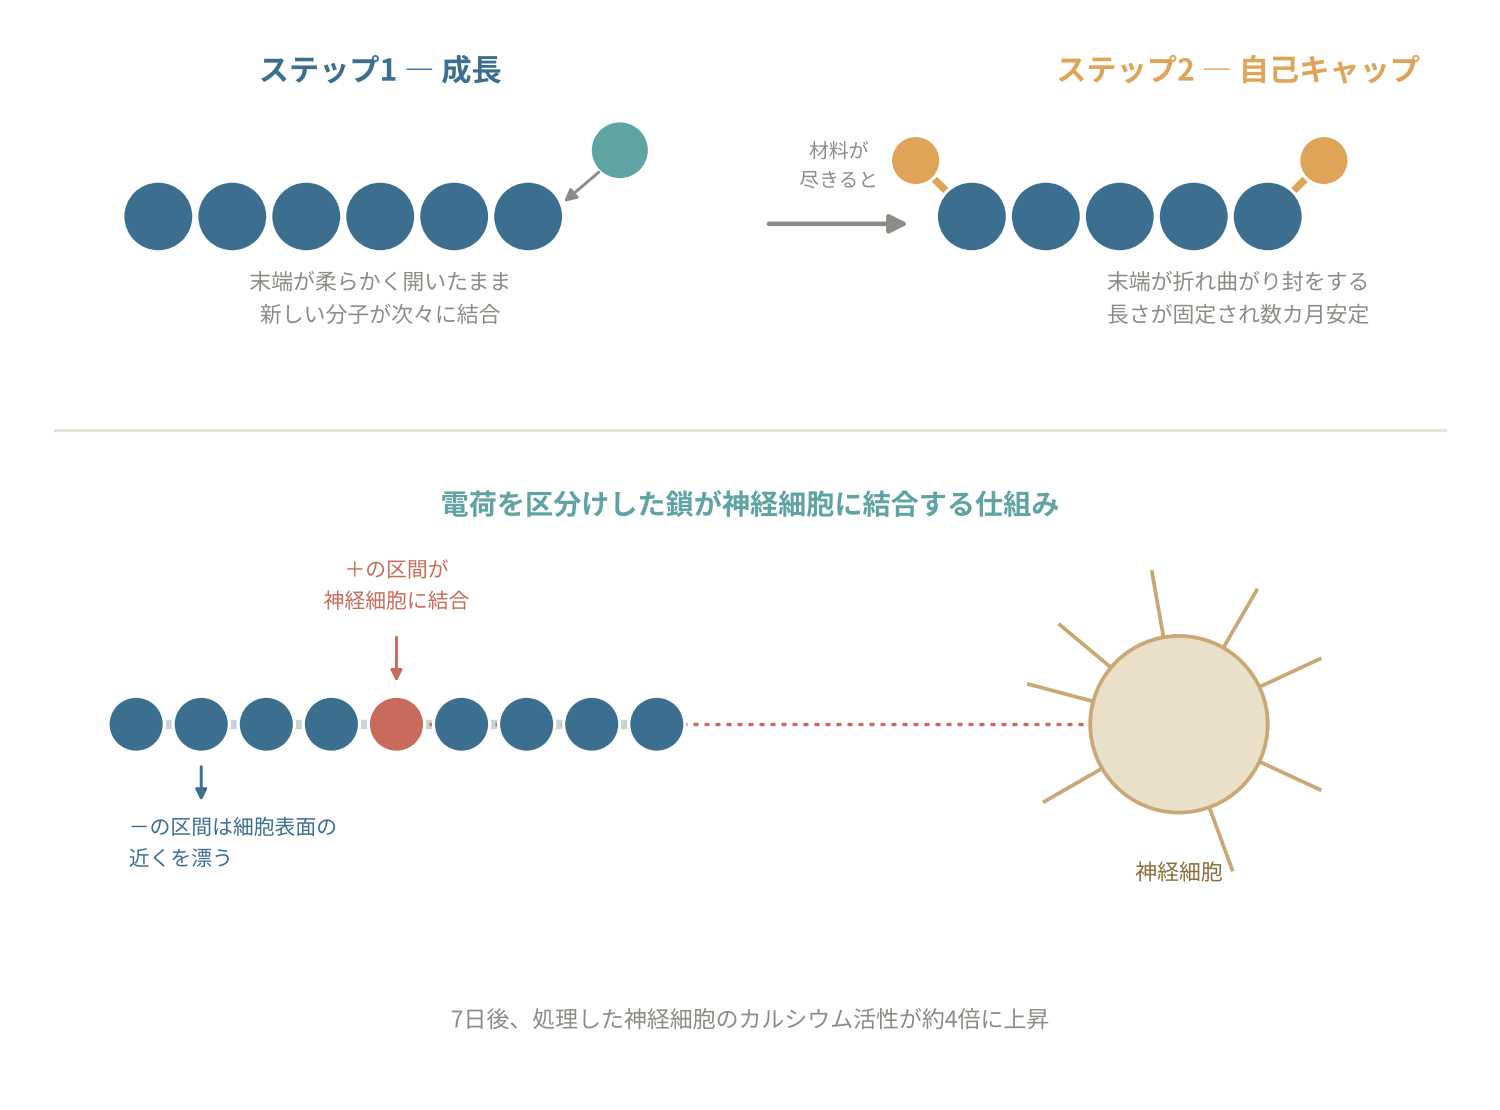
    化学者たちは、鎖が制御された長さで成長を止める方法も編み出してきました。その一例が2026年10月にノースウェスタン大学が発表した「自己キャップ型超分子重合」です。条件が整っている間は鎖の柔らかい末端が開いたまま新しい部品を取り込み続け、やがて折れ曲がって末端にふたをすることで成長を止めます。後から部品を加えれば成長を再開でき、研究者は鎖を好きな長さまで伸ばし、異なる性質の区間を配置できます。結びつきが弱すぎれば短く不安定な塊しかできず、強すぎれば組み替えられる柔軟性が失われるため、このバランスを取りつつ鎖同士の予期せぬ融合や分解を防ぐことが、精密な超分子設計を難しくしている要因です。

    なぜ今注目されているのか

    超分子ポリマーの研究自体は1980年代後半から続いています。1988年に化学者の相田卓三らが、円盤状の分子が非共有結合で連なり一次元の集合体を作る成果を報告したのを皮切りに、1989〜1990年には化学者ジャン・フレシェやノーベル賞学者ジャン=マリー・レーンのグループが水素結合による液晶性の超分子ポリマーを実証し、1997年には化学者バート・マイヤーの研究が、非共有結合の集合体でも本物の高分子のように力学的にふるまえることを示しました。それ以降に変わったのは「精密さ」です。超分子ポリマーは長年、長さが不揃いで制御しづらく、用途に向けて性質を狙い通りに設計することが難しいという課題を抱えていました。

    この課題に挑んだのが、材料科学者サミュエル・I・スタップが率い、博士研究員のマイケル・ドアらが参加したノースウェスタン大学のチームで、2026年10月1日に学術誌Scienceで研究成果を発表しました。自己キャップ型の手法により、分子量が数十億ダルトンに達する鎖の作製に成功。大学側の比較によれば、これは一般的な合成高分子や既知で最大級の天然タンパク質のおよそ100倍の重さに相当し、最も長い鎖は細胞一個分の幅よりも大きくなりました。研究者らによれば、この鎖は試験管の中で数カ月間、くっついて塊になったり融合したり徐々にバラバラに戻ったりすることなく、試験した条件下で制御された長さを保ち続けました。これは従来の超分子ポリマーが苦手としてきた点です。

    「これは、材料が細胞とどのようにコミュニケーションできるかについて、まったく異なる考え方をもたらすものです」。ノースウェスタン大学のサミュエル・I・スタップ氏は、この成果についてこう述べています。

    自己キャップ型超分子重合と、電荷を区分けした鎖が神経細胞に結合する仕組みを示した図解
    出典: Dore et al., Science(2026年)およびノースウェスタン大学のプレスリリースをもとに作成

    応用例――自己修復材料から神経細胞まで

    超分子ポリマーの中心にある可逆的な結合は、すでにいくつもの用途を見据えています。自己修復コーティングや建設・自動車・航空宇宙向けの部品は、小さなひび割れを部品交換なしに自ら修復し、機器の寿命を延ばせる可能性があります。刺激応答型のものは体内のpH変化などに触れたときだけ薬剤を放出するドラッグデリバリーの担体として研究が進み、水を含んだ超分子ハイドロゲルは細胞を育てる足場として組織工学で使われています。腐食や摩耗に強い適応型コーティングや、生体組織のようにしなやかに動くソフトロボティクスへの応用も試みられています。

    ノースウェスタン大学の研究は、ここに印象的な新例を加えました。研究チームは培養皿の神経細胞にいくつかの電荷パターンを試したところ、正の電荷だけの鎖は細胞に害を与え、負の電荷だけの鎖はほとんど影響を与えず、電荷をランダムに混ぜた鎖も目立った反応を示しませんでした。うまく機能したのは一つの設計だけで、短い正の区間を二つの長い負の区間で挟んだ構造です。これが負に帯電した神経細胞の表面に結合しました。この条件では、7日後に測定されたカルシウム活性(細胞内シグナル伝達の指標であり、神経細胞全体の機能を直接示すものではありません)が約4倍に上昇し、14日後にはより多くのシナプス結合が形成されていました。しかもこれは、通常使われる生体由来の成長因子を一切加えずに起きた変化です。研究者らは、これはあくまで培養細胞での実験であり動物や人間での試験はまだで、神経修復への医療応用は長期的な見通しにとどまると注意を促しています。

    関連する最新動向

    市場調査会社Transparency Market Researchの推計では、超分子ポリマーの世界市場規模は2024年時点でおよそ2億9,150万ドルとされ、2031年にかけて年平均約6.5%の成長が見込まれています。ただし科学的により重要な今後の節目は、ノースウェスタン大学が示したような数十億ダルトン規模の精密な鎖を、培養皿での実験を超えてスケールアップし、生きた動物で試験できるかどうかという点でしょう。

    上で紹介した「10億ダルトン」規模の鎖が、どのように神経細胞の活動を高めたのかについては、関連記事: 細胞より長い「10億ダルトン」の人工集合体を合成――神経細胞のカルシウム活性を4倍に高めた新素材でも詳しく紹介しています。

    出典: ノースウェスタン大学 Weinberg College、EurekAlert!プレスリリース、IUPAC Gold Book

  • 【科学】認知オフローディングとは?3分でわかる仕組みと注意点

    【科学】認知オフローディングとは?3分でわかる仕組みと注意点

    予定をスマホのリマインダーに任せる。長い報告書を自分で読む代わりにAIチャットボットに要約させる。こうした行動は心理学で「認知オフローディング(Cognitive Offloading)」と呼ばれます。この習慣自体は大昔からあるものですが、近年の研究は「道具が手元にないとき、自分の実力はどうなっているのか」という、より踏み込んだ問いを投げかけ始めています。

    元論文情報
    原題: Cognitive Offloading
    著者: Evan F. Risko, Sam J. Gilbert
    掲載誌: Trends in Cognitive Sciences, Vol. 20, No. 9, pp. 676–688 (2016)
    DOI: 10.1016/j.tics.2016.07.002

    認知オフローディングとは何か

    認知オフローディングとは、身体的な動作や外部の道具を使って、本来なら頭の中だけで行う作業の負担を減らすことです。カナダ・ウォータールー大学のエヴァン・リスコ氏と、英UCLのサム・ギルバート氏が2016年に学術誌『Trends in Cognitive Sciences』で発表したレビュー論文が、今もこの分野で最も参照される枠組みです。問題を完全に「頭の中」だけで解くのではなく、作業の一部を体や周囲の環境に肩代わりさせる、という考え方です。

    スマートフォンよりはるかに古い行動でもあります。逆さまの文字を読むために頭を傾ける、指を折って数える、電話番号を紙切れにメモする――これらもすべて認知オフローディングの一種です。変わったのは道具の規模と性能で、電卓やGPS、検索エンジン、そして生成AIアシスタントが、一連の思考プロセスそのものを肩代わりできるようになりました。この考え方は、哲学者アンディ・クラークらが1998年に提唱した「拡張された心(extended mind)」という理論とも近い関係にあります。いつも持ち歩くノートは、実用上その人の記憶システムの一部になりうる、という主張です。

    仕組み:スイッチではなく意思決定のループ

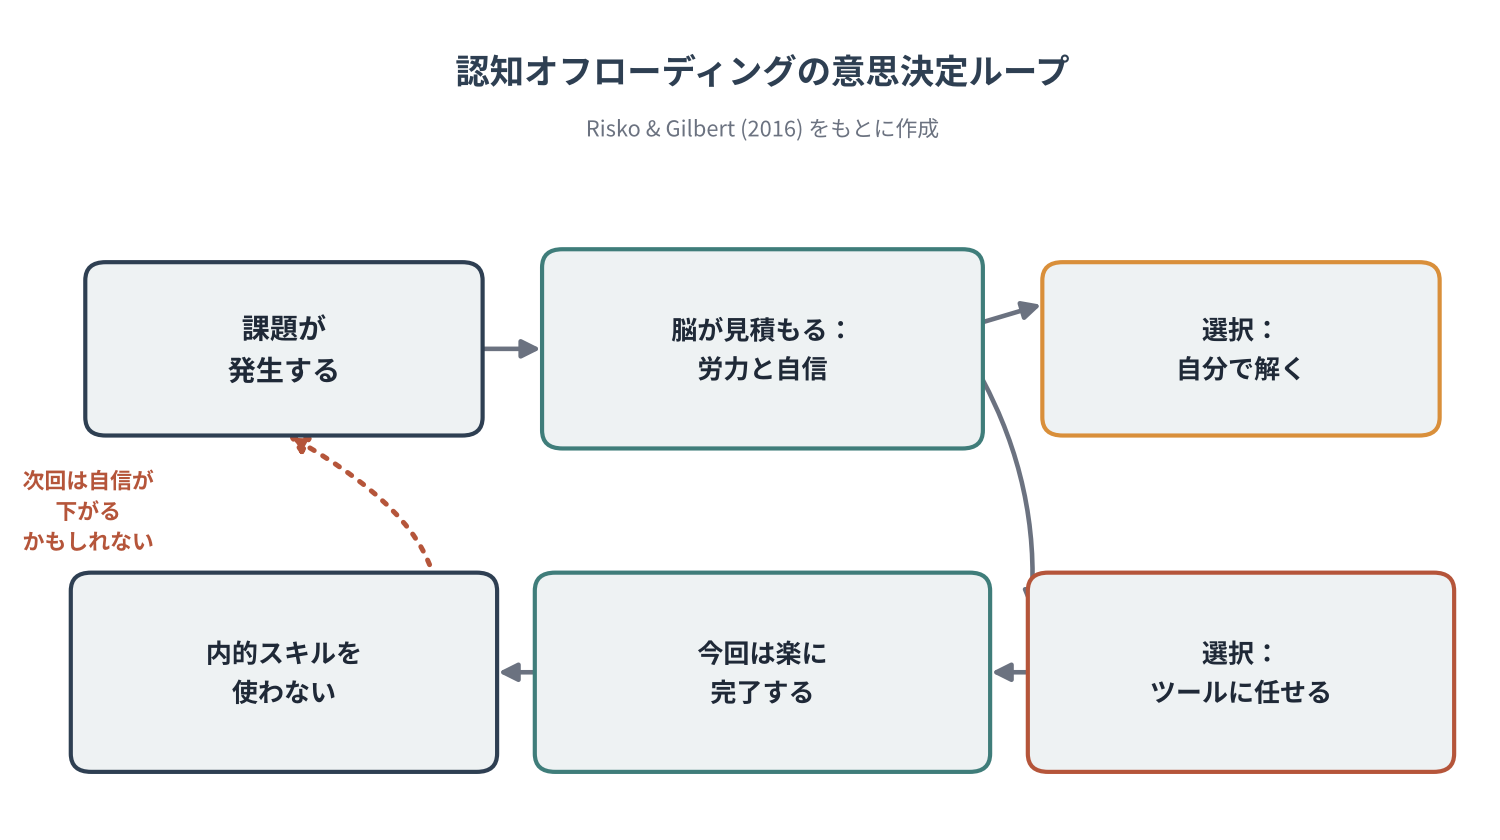
    帰り道に5つの用事を覚えておくよう頼まれた場面を想像してください。すべて頭の中で保持することもできますし、書き出すこともできます。リスコ氏とギルバート氏の枠組みでは、これを一度きりの選択ではなく、常に走り続けるコスト・ベネフィット計算の結果として捉えます。判断材料は、作業がどれだけ大変に感じられるか、自分の記憶力への自信、そしてリストを書く手間がどれだけ労力を節約するか、です。

    重要なのは、この計算が働くのは「実際の能力」ではなく「本人が感じる負担」と「自信」だという点です。自己評価は的外れなこともあり、本当は自力で対応できる場面でも外部の助けに頼ってしまうことがあります。道具への依存を繰り返すことで長期的に自信や素の実力が変化するのかは、関連はしていても別の、より検証が難しい問いです。オフロード自体が悪いわけではなく――忙しい週に買い物リストで記憶を補うのは理にかなった選択です――ただ、無意識の習慣になっていないか気に留める価値はあるでしょう。

    認知オフローディングの意思決定ループを示す図
    出典: Risko & Gilbert (2016), Trends in Cognitive Sciencesをもとに作成

    なぜ今あらためて注目されているか

    認知オフローディング自体は何十年も研究されてきたテーマですが、生成AIの登場によって、ニッチな学術トピックから一般的な関心事へと広がりました。2011年に『Science』誌に発表されたベッツィー・スパロウ氏らの研究はよく知られています。情報がオンライン上でいつでも参照できると信じると、人は情報の中身より「どこにあるか」をよく覚えている――いわゆる「グーグル効果」です。ただしこれはあくまで有益な歴史的類推です。検索エンジンは主に情報を保存・検索するだけですが、AIアシスタントは推論のような処理や文章の下書き、要約までこなします。研究者たちもこの違いを独自のテーマとして研究を始めたばかりです。

    研究者が今問うているのは、人がAIに思考を委ねるかどうかではなく、AIが手元にないときに自分の判断力をどれだけ失っているか、ということだ。

    2025年に『Societies』誌に掲載されたマイケル・ゲルリッヒ氏の研究は、666人を対象に、AIツールを頻繁に使う人ほど批判的思考力のスコアが低いという統計的に有意な負の相関を報告しました。特に若くAI依存度が高い層ほどスコアが低い傾向でした。ただし同じ時点で両方を測定した横断的研究のため、AI利用が思考力を弱めているのか、もともと能力の異なる人が使い方を変えているだけなのかは見分けられません。それでも同じ問いを別角度から示す研究は積み重なりつつあります。

    身近な具体例

    認知オフローディングは、自覚している以上に日常のあちこちに現れます。買い物リストを書いて記憶に頼らない、スマホのカレンダーにすべての予定を管理させる、経路を覚える代わりにGPSナビに目的地を打ち込む、事実を思い出す代わりに検索エンジンに尋ねる――どれもよくある例です。多くの場合、この取引は十分に見合うもので、買い物リストは記憶力をそれほど犠牲にせず用事を終わらせる助けになります。研究者が関心を持つのは、どのタイプのオフロードがこの「割に合う取引」に近く、どのタイプが後々の自力での実力により大きな代償を伴うのか、という点です。

    2020年に『Scientific Reports』誌に発表された、マギル大学のルイーザ・ダマニ氏らの研究は、この取引をGPSで直接検証しました。日常的に運転する50人の調査で、GPSの利用頻度が高い人ほどGPSなしでの空間記憶の成績が弱い傾向が見られ、約3年後に13人を再調査したところ、GPS利用がより増えた人ほど低下も大きいという対応関係も確認されました。著者らはこれをGPS利用が低下を招く方向の説明として支持しつつも、サンプルが小さく因果関係は完全には決着していないと注意を促しています。

    記憶だけがオフロードの対象ではありません。物の位置を覚える代わりに指でさすといった身体へのオフロードや、付箋やスマホの通知に「後で行動を思い出す」役目を託す「意図のオフロード」もあります。似て非なる概念が「自動化」で、利用者の判断を介さずシステムが作業を完結させる仕組みです。聞かずに経路を変更するGPSアプリは単純なオフロードを超えており、自分で判断を下す機会がなくなったときスキルがどうなるかは、また別の問いです。

    最新の研究動向

    最近の研究で最も明快な実証例が、2026年発表のカリフォルニア大学バークレー校主導の研究です。研究チームは計1,222人を対象に、ChatGPTを使える条件・使えない条件で数学や読解の問題を解かせる3つのランダム化比較試験を実施し、その後全員が最後の問題セットを完全に自力で解きました。結果、それまでAIに頼っていた参加者は最初から自力だった参加者より成績が明らかに低くなりました――ある実験では正答率57%対73%です。関連記事: AIに10分頼ると「粘り強さ」が落ちる――バークレー大学の実験で判明に詳しい結果と限界が整理されています。

    だからといって、オフロードが単純に悪いわけではありません。同じ研究の自己申告に基づく(ランダム化されていない)分析では、AIの答えをそのまま書き写したと答えた参加者の正答率は平均65%と最も低く、ヒント程度にしか使わなかった参加者はAI不使用の参加者に近い成績でした。確定的な結果とは言えませんが、示唆に富む傾向です。見えてくるのは、「オフロードするかどうか」より「どう使うか」が重要だというテーマです。完成した答えへの近道として使うのと、自分で考える過程を保つ足場として使うのとでは、効果の現れ方が違うようです。

    出典: Risko & Gilbert, “Cognitive Offloading,” Trends in Cognitive Sciences (2016)、Gerlich, “AI Tools in Society,” Societies (2025)、Columbia News(Sparrow et al., Science, 2011の紹介記事)、American Psychological Association Monitor (2026)

    あわせて読みたい: AIに10分頼ると「粘り強さ」が落ちる、AIの要約が記憶を歪める。