交差点に近づく車の短い映像を見て、標識を確認し、歩行者がはねられる場面を目撃したとする。翌日、その映像を要約したAIの文章を読む。ただし要約には、標識の種類を取り違える誤りが一つだけ紛れ込んでいた。後で「実際に見た標識はどちらか」と尋ねられると、正答率は目に見えて下がってしまう——これが、ジョージタウン大学とワシントン大学の研究チームが新たに示した結果だ。誤りを含むAI要約は、自分が直接目撃した出来事の記憶そのものを歪めうる。AIによる要約はすでに報道やオフィス業務、警察の捜査にまで広がりつつあるだけに、見過ごせない指摘だ。
AI要約はすでに身近な存在に
ChatGPTやGeminiのような大規模言語モデルは、会議の録画やニュース映像、監視カメラ映像を数行の箇条書きに要約する用途ですでに日常的に使われている。米国の一部の警察では一歩進んで、ボディカメラの音声を文字起こしし、そこから報告書の文章案を自動生成するツールの導入も始まっている。代表例であるAxon社の「Draft One」は、通報対応後数分で報告書の下書きを作成し、最終的に警察官自身が内容を確認・承認する仕組みだ。米コロラド州フォートコリンズ警察では、導入後に報告書作成にかかる時間が82%減ったと報告されている。ただしこのツールは音声の文字起こしから文章を作る仕組みで、映像を要約する今回の研究対象とは異なり、今回の研究で直接検証されたわけではない。それでも、正確さが重要な場面にAIが書いた文章が急速に入り込みつつある現実を物語る。
筆頭著者でジョージタウン大学の助教研究員、マッテア・シム氏は「AIは誤情報を広める新しい手段になっている」と指摘する。共著者で、警察とテクノロジーの関係を研究するワシントン大学のヤエル・アイガー氏は、「警察がこうした映像要約技術を、十分な検証もないまま使っている可能性があるのが気がかりだ」とさらに踏み込む。
事故映像で記憶をテスト
研究チームはまず、ChatGPT-5.5とGemini 2.5 Flash-Liteの2モデルに、車と歩行者の衝突を描いた短いアニメーション映像を要約させた。用意した映像は2種類で、内容はほぼ同一だが、交差点の標識だけが「一時停止」か「徐行」かで異なる。各モデルにそれぞれの映像を5回ずつ要約させ、合計20本の要約文を作成した。
次に360人の参加者を募り、2種類のうちいずれか一方の映像を視聴してもらった。その1〜2日後、参加者は自分が見た映像の要約文を読む。要約は正確な内容のものか、標識の種類を取り違える誤りが一つだけ埋め込まれたもののいずれかで、さらに「AIが書いた」「人間の書き起こし担当者が書いた」のどちらかをランダムに伝えられた。360人のうち、両段階を完了し注意力チェックに合格したのは328人だった。
要約の半数が核心を省略
研究チームはまず、作成した20本のAI要約を、あらかじめ定めた「事故の核心にあたる情報」のリストと照らして採点した。結果は芳しくなく、要約は平均して核心情報の51.6%を省略し、20本中19本が最重要の事実である「車が歩行者をはねた」ことに触れていなかった。
2モデルには違いもあった。標識の種類のような重要な事実を取り違える「致命的な誤り」は、Geminiの要約では100%の割合で見られたのに対し、ChatGPTでは30%にとどまった。両モデルとも、映像に存在しない内容を作り出す「ハルシネーション」と呼ばれる誤りも時折見られた。なおこれらの数値は2本の短い映像・2モデルという限られた条件での結果であり、AI要約全般の一般的な誤り率ではなく、「深刻な誤りが起こりうる」事例と捉えるべきだ。
「AIには、敵意や悪意がなくても誤情報を生み出してしまう可能性がある」と、研究チームは論文に記している。
誤った要約で正答率がほぼ半減
2段階目の実験では、こうした誤りが要約の中だけにとどまらず、人が実際に見た出来事の記憶そのものに影響することが示された。正確な要約を読んだグループは、標識を問う質問に83.6%の確率で正しく答えられた。これに対し、誤りのある要約を読んだグループの正答率は44.8%にまで下がった。この差は統計的に有意で、単なる偶然では説明しにくいと研究チームは結論づけている。
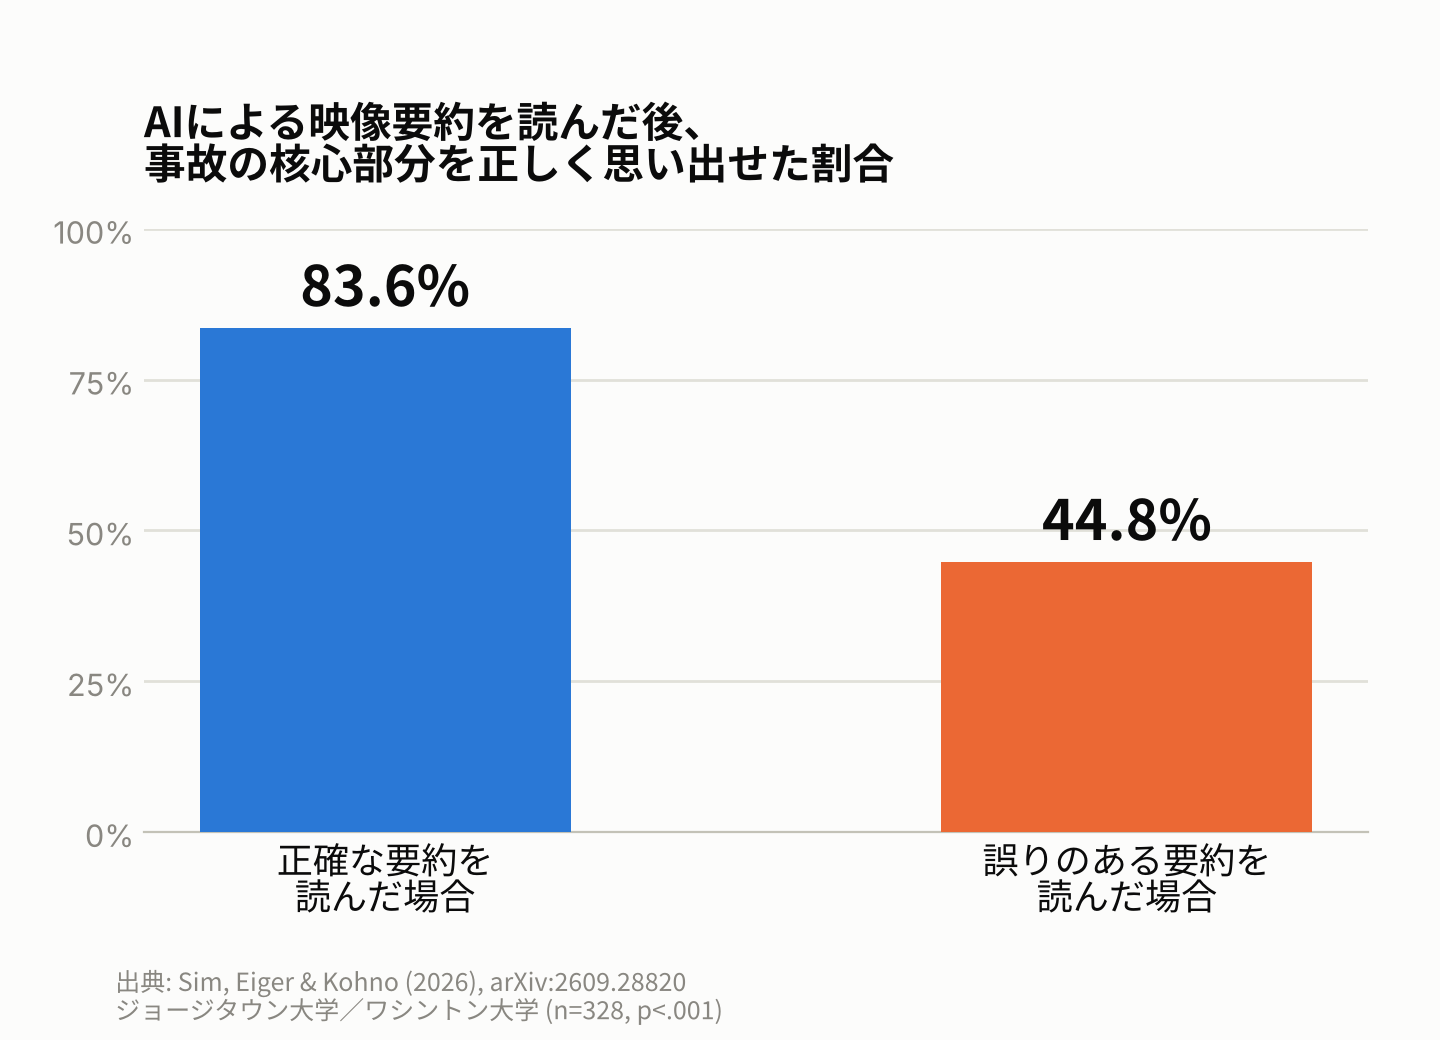
この38.8ポイントの差こそが、今回の研究の核心的な発見だ。一見ごく普通の要約に紛れ込んだ、たった一つの誤った情報が、わずか1〜2日前に自分の目で見た出来事の記憶を大きく揺るがすのに十分だった。ただしこの実験が示すのは明確な「誤情報効果」であり、元の記憶が完全に消去・書き換えられたことまで証明するものではない。確かなのは、この特定の事実についての想起の正確さが大きく損なわれた、という点だ。
AIだと伝えても効果なし
興味深いのは「効かなかった要因」だ。要約を「AIが書いた」と伝えられたグループは、「人間が書いた」と伝えられたグループと比べて、誤りを見抜きやすいわけでも騙されにくいわけでもなかった。正答率はそれぞれ46.3%と43.4%で、統計的に意味のある差とは言えない。AIへの信頼度や利用頻度も、騙されやすさに測定可能な影響を与えなかった。
つまり今回の実験の範囲では、要約に「AI製」とラベルを付けるだけでは誤りの影響は弱まらなかった。研究チームは、この結果が「人間が最終確認すればAIのミスは防げる」というAI安全性をめぐる一般的な前提に疑問を投げかけると指摘する。誤った要約が確認者自身の記憶を静かに書き換えてしまうなら、ミスに気づく手立てそのものが失われかねない。なお今回検証されたのは「誰が書いたかのラベル」だけで、元の映像と突き合わせて事実を確認するといった、より踏み込んだ手順の効果までは検証していない。
司法と警察現場への教訓
今回の実験で使われたのはアニメーション映像で、参加者も一般から募った被験者であり、実際の警察官や目撃者、実際の事件ではない。それでも警察現場に関連づけられる理由はより一般的なところにある。AIが生成した説明が、人が出来事を思い出す手がかりの一部になると、その誤りが後の記憶に影響しうるという点だ。警察官や目撃者が正式な供述の前に誤りを含むAI要約を読めば、その後の証言に影響が及ぶ可能性がある――現実的な懸念だが、今回の研究自体が直接検証したわけではない。
これは人間側だけの弱点でもない。本サイトで以前取り上げた動きの錯覚に関する過去記事では、AIの画像認識が人間の目を惑わす「動きの錯覚」を同じようには再現しないことを報告した。AIと人間の知覚のズレは双方向に生じうるということであり、どちらか一方を鵜呑みにして他方の確認役にはできない。
今回の研究の縮約版は今週、スウェーデン・マルメで開催中の「第9回AAAI/ACM AI・倫理・社会会議(AIES 2026、10月12〜14日)」で発表された。論文自体は9月にプレプリントとして先行公開済みだ。著者らはAI要約を重要な場面から一律に排除すべきだと主張しているわけではないが、法的判断に関わる場面で信頼される前に、誤り率を測定・開示する必要があると強調する。
研究チームは未検証の点にも率直だ。使用したのはChatGPTとGeminiの一般消費者向け版のみで、Axonのようなベンダーが実際に使う企業向け・調整済みモデルは対象外だった。アイガー氏は、ベンダーが実際にどのモデル・設定を使っているか外部から見えにくいこと自体が問題だと話す。シム氏は次の一歩として、実際のボディカメラ映像と警察報告書を対象に、AI要約が警察と市民のやり取りへの人々の判断をどう左右するか調べたいとしている。
Xsciens編集部の読み解き
この研究が突きつけるのは「AIは間違える」という当たり前の事実より、間違いが人間の記憶そのものに入り込み、確認する側の判断を静かにゆがめうるという点です。
- 38.8ポイントの差の前提を押さえる。正答率は、正確な要約を読んだ群で83.6%、誤りを含む要約を読んだ群で44.8%でした。ただし対象は、2本の短いアニメーション映像と2つのAIモデル、最終的に分析に残った328人という限られた条件です。AI要約全般の誤り率ではありません。
- 「AI製」のラベルでは防げなかった。AIが書いたと伝えられた群の正答率は46.3%、人間が書いたと伝えられた群は43.4%で、意味のある差はありませんでした。一方、元の映像と突き合わせるなどの確認手順の効果は検証されていません。「人間が最終確認すれば安全」という前提を否定したというより、確認の方法を設計し直す必要を示した結果です。
- 警察の実運用ツールを直接検証したものではない。記事にある警察向けツールは音声の文字起こしから文章を作る仕組みで、今回の研究は映像の要約が対象です。実際のベンダーが使う調整済みモデルも検証されていません。
- 編集部の想像(推測)――私たちは、将来のAI要約が「この一文は映像の何秒目に基づく」と根拠の場面をその場で示してくれるようになれば、確認の手間が減り、誤りに気づきやすくなるかもしれないと考えています。たとえば会議の録画を要約するとき、気になる一文を押すと元の発言に飛べる、といった使い方です。ただし、根拠が示されても人が確認を省けば同じ問題は残りうるので、これはあくまで編集部の推測です。
この読み解きの参考: ジョージタウン大学の発表、論文(arXiv:2609.28820)、Loftus & Palmer(1974)の古典実験の解説(SimplyPsychology)
出典: ジョージタウン大学 “New Research Finds That Misleading AI-Generated Summaries Can Distort Human Memory”、Sim, Eiger & Kohno, “AI-Enabled Human Memory Manipulation” (arXiv:2609.28820)、Axon “Axon Reimagines Report Writing With Draft One” (Officer.com掲載)
関連記事
あわせて読みたい: AIに判断や記憶を任せると何が起きるかは認知オフローディングとは?3分でわかる仕組みと注意点で解説しています。