何かが動くのを見た直後、人は静止している物体の位置を一瞬見誤ってしまう――そして同じようなズレが、サルの脳から記録された信号にも現れることが新しい研究で分かった。一方、人間の視覚を模倣するよう作られた7種類のAI画像認識モデルは、そのズレをまったく再現しなかった。2026年10月2日に学術誌Current Biologyに掲載されたこのカナダ・ヨーク大学(トロント)の研究は、この差が実際のAI画像認識システムの不具合につながると証明したわけではない。ただ、変化し続ける場面を追い続ける必要がある自動運転車やロボットなどを開発するエンジニアにとって、自分たちのシステムが生物の視覚と同じように直前の視覚情報を扱えているかどうかを確かめる、具体的で再現可能な指標を提供するものだ。
1枚の静止画像の中で物体を正しく言い当てられるかという頻度――こうした静止画ベースの指標は、これまでコンピュータービジョン研究の主役だった。しかし実際のカメラが世界を1枚の静止画として捉えることはほとんどなく、直前に何が起きたかによって形づくられる連続した映像として捉えている。注目すべきは、複数フレームの時間情報を使うよう設計された動画モデル(SlowFast)でさえ、生物の視覚に見られたズレを再現できなかった点だ。これは単にフレーム数を増やせば解決する問題ではなく、現在の仕組みが自力では学習できていない特定の「補正」の仕組みが欠けていることを示唆している。
動きを見た後、脳は位置を見誤る
研究チームが用いたのは、古典的な「運動残効」と呼ばれる錯視に関連する現象で、流れ落ちる滝をじっと見つめた人が最初に報告したことから「滝の錯視」とも呼ばれる。たとえば縞模様が左方向へ動き続ける様子をしばらく見た後に静止した物体を見ると、実際には画像(ピクセル)がまったく動いていないにもかかわらず、その物体が反対方向へわずかにずれて見えることがある。ヨーク大学の研究チームは、この位置のズレを単なる目の錯覚として片付けるのではなく、脳が物体の位置をどのように表現しているかを調べるための、精密で測定可能な手がかりとして利用した。
サル・ヒト・AIで同じ実験
責任著者のコヒティジ・カー氏と筆頭著者のエリザベタ・ヤクボフスカヤ氏が率いる研究チームは、3種類の大きく異なる視覚システムに、それぞれに合わせた同種の実験を行った。79人の人間の被験者は、動きのない基準群35人と、左右いずれかの方向への動きに順応させた後に実験を行う22人ずつの2群に分けられ、0.1秒だけ表示される物体を見て、それがあったと思う位置をクリックした。2頭のアカゲザルには、慢性的に埋め込んだ電極アレイを通じて、物体認識に関わる脳の経路に属する下側頭皮質(IT野)から150個を超えるニューロンの信号を記録しながら、同様の映像を見せた。IT野の活動には、物体が「どこにあるか」という情報も同時に含まれていることが分かっている。同じ画像は、AlexNetやVGG-16のような古典的な画像分類モデルから、視覚用トランスフォーマー、動画行動認識モデルのSlowFastまで、広く使われる7種類のコンピュータービジョンモデルにも入力された。
AIは物体位置は分かるが錯覚は起きず
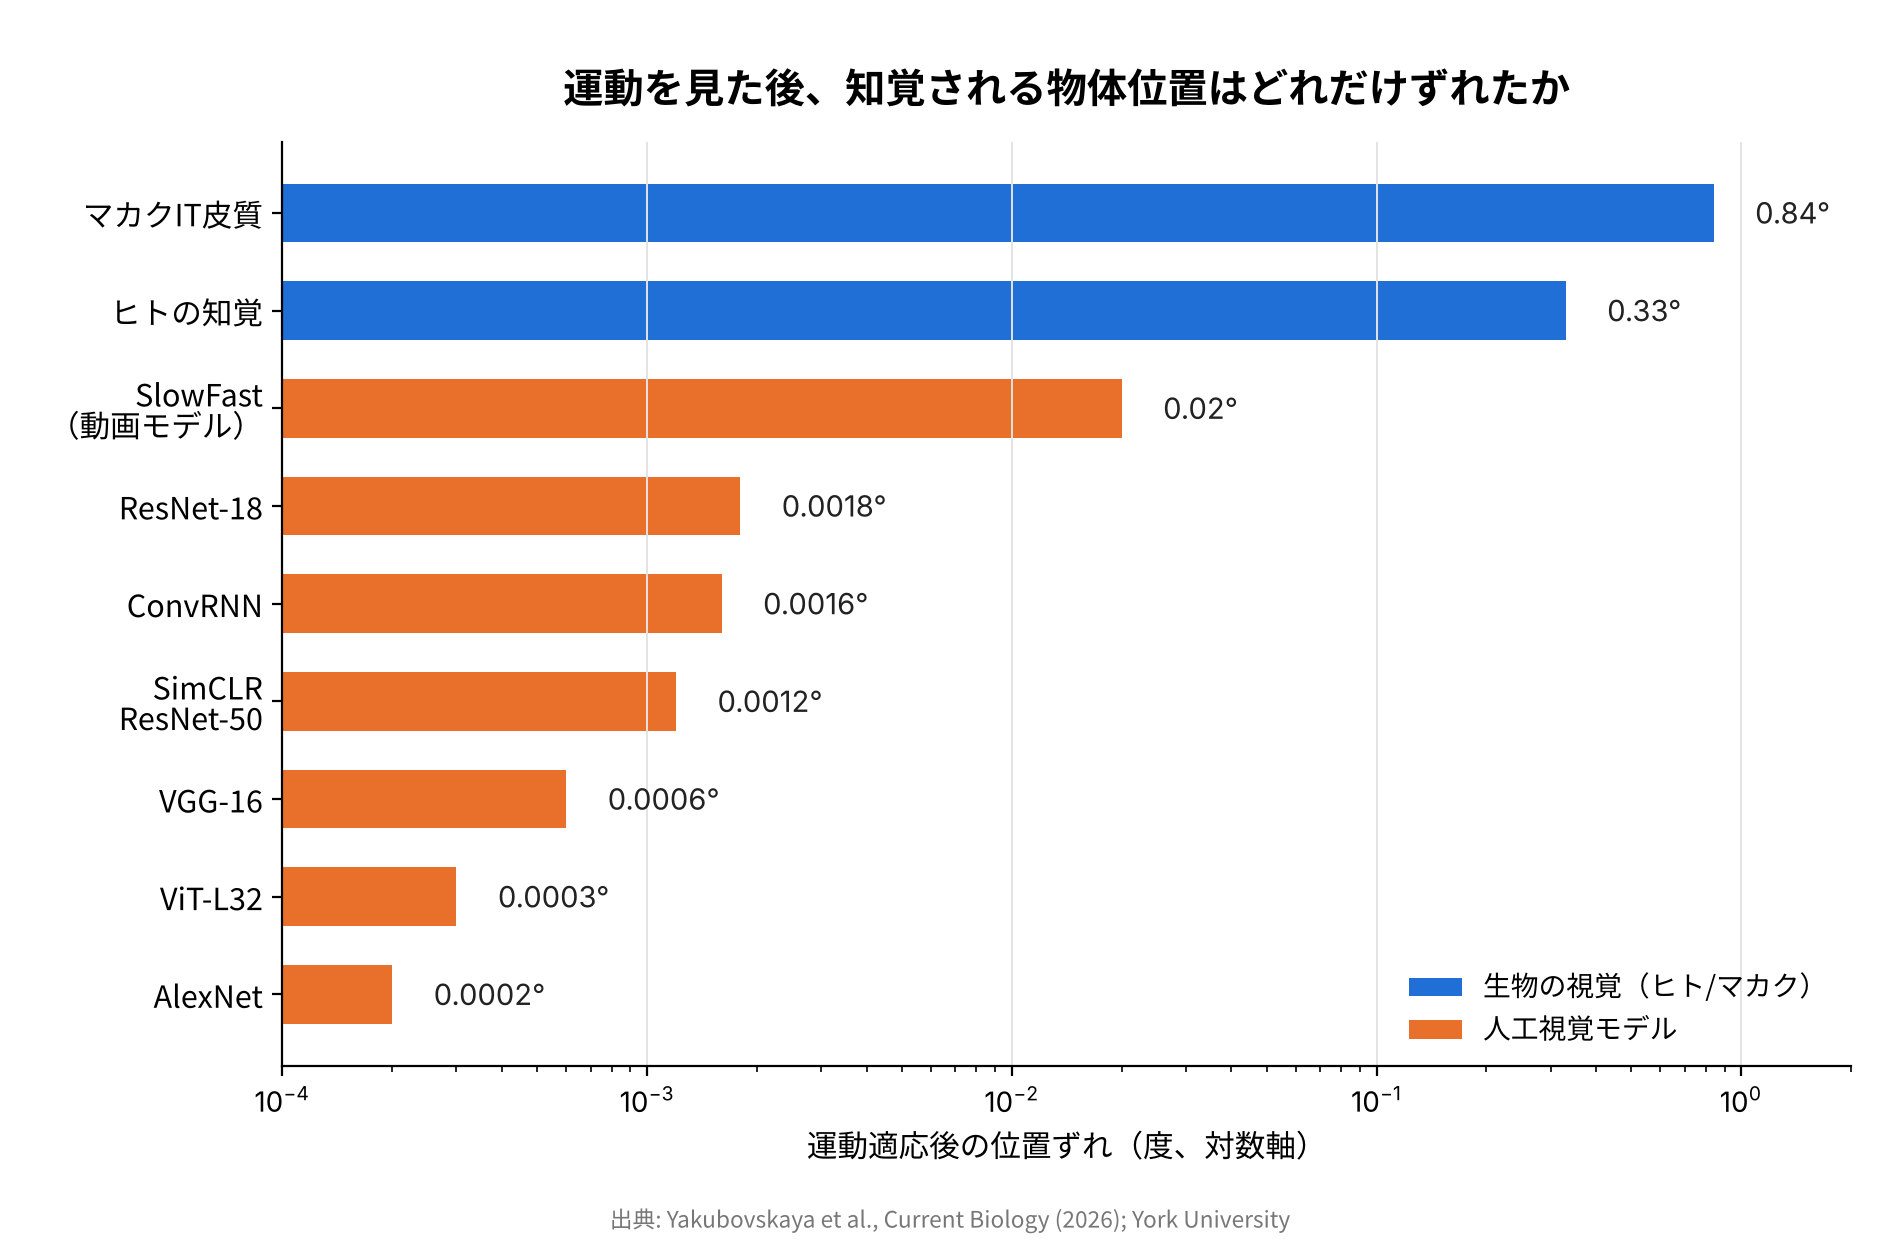
動きに順応させていない通常の画像では、脳の記録とAIモデルのどちらも、物体の実際の水平位置をきちんと捉えられていた。いくつかのAIモデルの線形読み出しは、サル自身のIT野の読み出しとおおむね同程度、真の位置との相関係数にしておよそ0.59から0.84の範囲で一致していた。つまりAIモデルは単純に位置特定が苦手だったわけではない。違いが現れたのは、動きに順応させた後だけだった。人間の被験者は、直前の動きとは逆方向に、視角にして平均0.33度、物体の位置がずれて見えたと報告した。サルのIT野の集団活動から読み取った位置は、同じ方向にさらに大きく0.84度ずれていた。ただしこの数値は意識的に見えた位置そのものではなく、神経活動から復元(デコード)された信号であることに注意が必要だ。一方、動画ベースのSlowFastを含め、テストされたすべてのAIモデルのズレは0.02度以下にとどまり、実質的にほとんど変化がなかったといえる。
人間の知覚は動きを見た後に平均0.33度ずれ、サルのIT野から読み取った位置は0.84度ずれた――一方、テストされたすべてのAI画像認識モデルのズレは0.02度以下にとどまった。
脳の補正パターンをAIに移植
この差は、AIモデルが位置のズレに関する情報をまったく表現できないということを意味するわけではなかった。研究チームが、動きへの順応時にIT野のニューロンの反応がどう変化したかから導いた数学的な変換を、AIモデルの内部の特徴表現に直接適用したところ、モデルも人間に似た位置のズレを示すようになった。これは、外部から適切な変換を加えさえすれば、AIモデルの特徴空間がこの効果を再現できる可能性があることを示している。しかし、どのモデルも通常の学習だけでこの適応を自力で獲得していたわけではなく、それこそが研究チームが指摘する「欠けている部分」だ。脳自身の計算の仕組み――最終的な答えだけでなく――を手がかりにAIの設計に役立てようという考え方は、今回が初めてではない。人が何かを選んだ瞬間に脳内の情報がどう並べ替えられるかを調べた別の研究でも、最終出力だけでなく神経コードそのものを参考にすべきだという、似た立場が示されていた。
まだ欠陥でなく検証すべき差
研究チームは、今回の結果を「表現のしかたに実証された違いがある」という範囲にとどめ、「AIの視覚の性能が実際に劣る」ことの証明だとは位置づけていない。それでも、検証する価値のある違いだと主張する。自動運転車や配達ロボット、監視システムはいずれも、直前の動きが次に何が起きるかに影響し得る、連続した映像の流れの中で物体の位置を判断している。たとえば、カメラの視界を横切る自転車を追跡するロボットを考えてみよう。現在の画像そのものは変化していなくても、直前の動きを受けて人間の知覚が変化するのと同じように、ロボットの位置推定も変化するかを検証できる。今回の研究は、この錯覚を再現すればシステムがより安全や高精度になるとまでは示していないが、その問いを検証する具体的で再現可能な手段を提供する。カー氏は、AIを最終的な答えの正しさだけで評価すると、こうした差を見落としかねないと主張する。出力だけでなく知覚を支える計算のしくみそのものを一致させることが、AIが変化する場面を人の期待通りに扱えているかを評価する助けになるかもしれない、という考えだ。
この研究が示さないこと
研究チームは、今回の研究の限界についても明確に述べている。実験に使われたのは2頭のサルと1種類の錯覚だけであり、他の知覚順応や、より多くの個体、あるいはIT野以外の視覚経路の段階にどこまで当てはまるのかは分かっていない。テストされたAIモデルは画像・動画認識のための標準的な研究用ネットワークであり、視覚と言語を組み合わせた最新のマルチモーダルAIアシスタントは対象外だ。また研究チームは、今回測定した知覚のズレそのものが日常の物体追跡に実際に役立っているとまでは主張しておらず、現在のAIのアーキテクチャが自力では再現できていない、霊長類の視覚における実在の計算処理を反映しているとするにとどめている。この「運動残効」自体が、他の研究機関や企業が自社の視覚モデルの対応力を検証するための、シンプルで再現可能なベンチマークになり得るとも提案している。カー氏の研究室はすでにその方向性を追求しており、物体を継続的に追跡するタスクに向けて、より霊長類に近い人工ニューラルネットワークの構築を進めているという。
出典: Yakubovskaya et al.,「The macaque IT cortex but not current artificial vision networks encode object position in perceptually aligned coordinates」, Current Biology (2026)、Yakubovskaya et al., arXivプレプリント (2026)、ヨーク大学のプレスリリース内容を報じたNeuroscience Newsの記事