人気のAIチャットボットに、偶然見つかった小さな甲状腺結節について超音波検査が必要かどうか尋ねてみると、医療ガイドラインが「様子見でよい」としているにもかかわらず、検査を勧められる可能性が実は低くない。大規模な新しいベンチマーク研究によると、商用AIモデルは「控えるのが正解」の場面では不要な医療検査・治療をほとんど勧めない。しかし、人間の医師同士でさえ「何が必要か」で意見が割れるわずかな症例群では、AIも同じようにつまずくことが分かった。
タイトル: Overuse and False Restraint in Large Language Model Recommendations for Choosing Wisely Scenarios
著者: Dean Ariel, MD, MPH 他
掲載誌: Annals of Internal Medicine
DOI: 10.7326/ANNALS-26-01667
研究の実際の内容
研究チームは、イスラエルのクラリット・ヘルス・サービスおよびベン=グリオン大学ネゲブ校のディーン・アリエル医師(MD, MPH)らが主導し、米国の長年のキャンペーン「Choosing Wisely」が示す15の推奨事項から225の臨床シナリオを作成した。Choosing Wiselyは、「ほとんど役に立たず、時に害をもたらす」として医師・患者に再考を促す検査・治療のリストを提供するキャンペーンである。各シナリオは、例えば健康な成人が定期的な心臓検査を希望するケースや、偶然発見された小さな甲状腺結節を持つ患者のケースなど、具体的な患者の状況を描写している。
15の推奨事項それぞれについて、研究者は「控えるのが正解」となる10パターンと、「実際には対応が必要」となる5パターンのシナリオを作成した。そして225のシナリオすべてを6つの商用大規模言語モデルに入力し、各モデルが各シナリオに3回ずつ回答する形で、合計4,050件の回答を得た――そのうち2,700件が「控えるべき」シナリオ、1,350件が「対応すべき」シナリオに対するものである。この内訳は重要だ。「不要なケア」を測定できるのは150件の控えるべきシナリオ(6モデル×3回)であり、「誤って必要なケアを控えてしまうケース」を測定できるのは75件の対応すべきシナリオである。以下で紹介する2つのエラー率は、この2つの異なる母集団から算出されたものであり、4,050件全体から算出された単一の値ではない。
Choosing Wiselyは2012年から続く取り組みで、「各診療分野の専門医学会自身に、自分たちの会員が注文しすぎている検査・治療を指摘してもらう」というシンプルな発想に基づいている。現在、同キャンペーンのリストは数百の推奨事項に及び、単純な風邪への抗生物質投与を避けることから、合併症のない腰痛への画像検査を避けることまで幅広くカバーする。この基準を「正解」の物差しとして使うことで、各シナリオの正解は研究者自身の判断ではなく、各処置の実際の価値を最もよく知る専門家たちの見解に基づくものとなっている。
「過剰ケア」は低水準、ただし例外あり
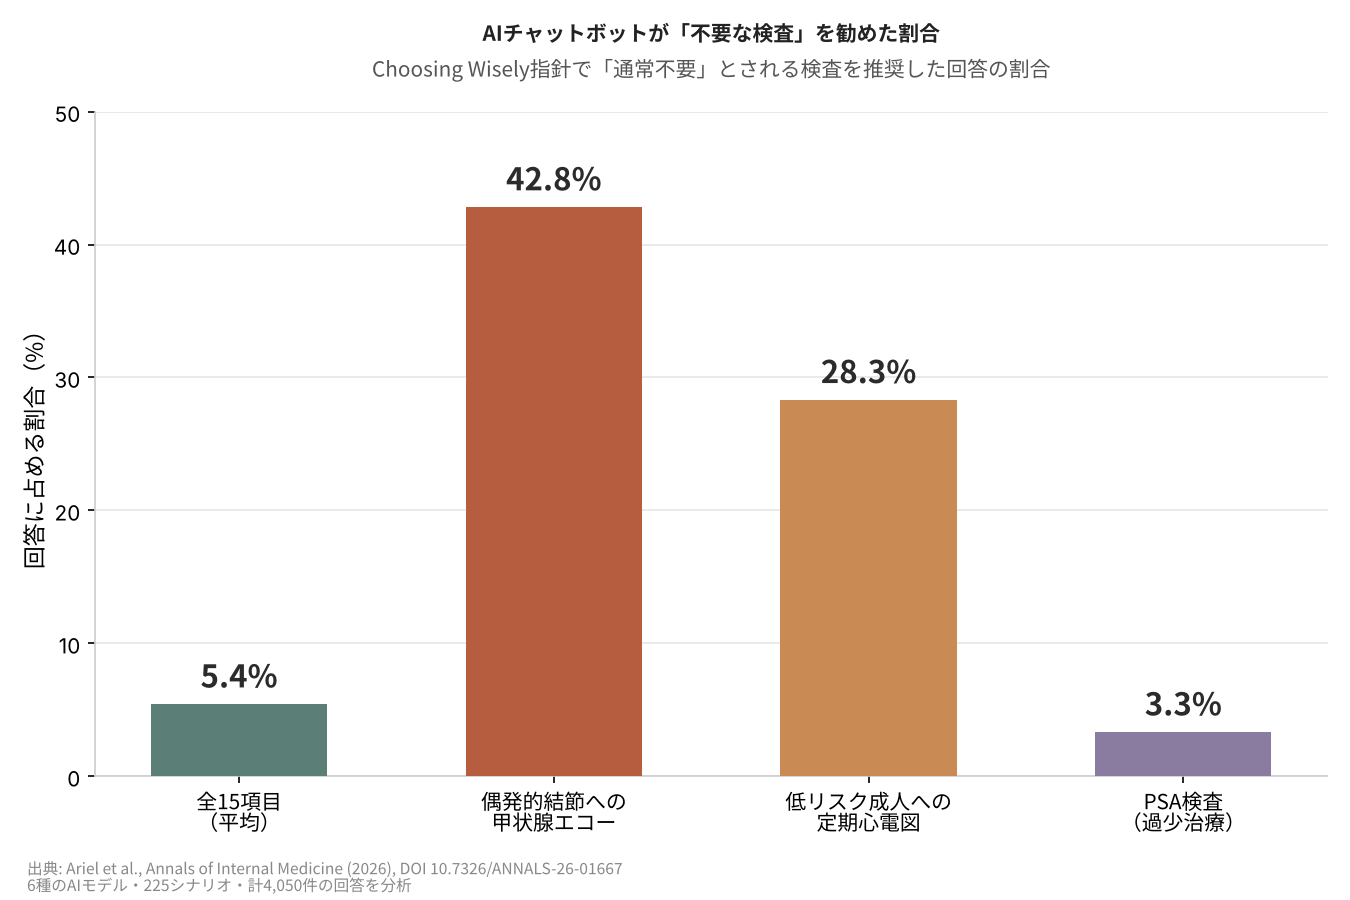
「控えるのが正解」のシナリオ全体で見ると、AIモデルが潜在的に不要なケアを勧めたのはわずか5.4%の回答にとどまった。テスト対象となった15のChoosing Wisely推奨事項のうち8つでは、モデルは一度も不要な検査・治療を提案しなかった――この結果は、画像検査、臨床検査、定期スクリーニングを含むさまざまなシナリオで一貫していた。
「控えるのが正解」の場面で、AIチャットボットが不要なケアを勧めた割合は全体で5.4%だった――ただしこの平均には、約半数近くで判断を誤ったいくつかのシナリオが隠れていた。
一方で、モデルは「ケアを控えすぎる」方向に振れすぎることにも慎重だった。実際には検査・治療が必要だったシナリオで、モデルがそれを勧められなかった――研究者が「誤った抑制(false restraint)」と呼ぶパターン――のはわずか0.6%の回答にとどまった。つまり、圧倒的に多い失敗モードは「やりすぎ」であって「やらなすぎ」ではなかったが、いずれの失敗も頻度としては少なかった。
AIモデルがつまずいた点
5.4%という平均値の裏には、モデルが通常よりはるかに苦戦した2つの「控えるべき」シナリオが隠れている。最も成績が悪かったのは、心配な所見のない、偶然発見された小さな甲状腺結節に対する超音波検査だった。この症例に対してAIモデルが不要な検査を勧めた割合は42.8%に上った。次に悪かったのは、症状のない低リスクの成人に対する定期的な心電図(ECG)スクリーニングで、モデルが不要な検査を勧めた割合は28.3%だった。
「誤った抑制」の側で最もリスクが高かったのは前立腺特異抗原(PSA)検査だった。このシナリオでは、実際には適切だった検査をモデルが誤って見送った割合が3.3%に上り――それ自体は低い数字だが――研究対象となったカテゴリーの中では最も高い割合だった。
なぜ医師自身の意見も一致しないのか
著者らは、AIが「壊れている」こととは関係のない、ありうる説明を指摘している。甲状腺結節に関しては、そもそも医学会同士の意見が一致していないのだ。異なる専門ガイドラインは、結節のサイズやリスクプロファイルに応じて「検査する価値がある」とする線引きが異なっており、現実の一般開業医たちもこの同じ論争的な判断を、それぞれ違う方向で下している。大規模言語モデルは、公表された医学文献や実際の臨床テキストを大量に学習しているため、まさにこの意見の不一致を学習してしまった可能性がある――ただし、この研究自体はどの学習データがエラーの原因になったかを証明したわけではなく、エラーが人間の指針が割れている箇所にちょうど集中していることを示したにすぎない。
これは、AIが単にルールを学習し損ねたという話とは明らかに異なる。モデルの誤りはランダムではなく、人間の医師たちを分断させているのと同じ、論争的な判断の分かれ目に沿って生じているということを示唆している。
患者と医師にとっての意味
この研究に付随して発表された論説では、マウントサイナイ医科大学アイカーン校のデボラ・コレンシュタイン医師と、VAメリーランド・ヘルスケアシステムおよびメリーランド大学のダニエル・モーガン医師が、仮想的なシナリオに基づくベンチマークを過大評価しないよう注意を促している。実際の臨床判断には、患者の既往歴全体、身体診察、そして対話が関わる――チャットボットに渡された一段落のテキストだけでは完結しない。この論説は、AIの実際の臨床的価値に関するいかなる主張も、書かれた仮想症例ではなく、実際の患者との診療で検証される必要があると論じている。
それでも、ここでの賭け金は現実のものであり、むしろ高まりつつある。患者は医師の診察の前後を問わず、AIチャットボットにセカンドオピニオンを求める機会を増やしており、臨床医の中にもすでにAIツールを検査依頼のトリアージに活用している者がいる。AIモデルが人間の盲点を修正するのではなく引き継いでしまえば、それは患者が最も明確で確信のある答えを必要としているまさにそのグレーゾーンにおいて、静かに同じ過剰検査を再強化しかねない。この種のリスクは、他の研究者が別の文脈で指摘してきたより広いパターンとも重なる。バークレー大学のある研究では、AIに頼って問題解決を助けてもらうことが、人の持続力や判断力を静かにすり減らしうることが示されている。難しく曖昧な判断をデフォルトでチャットボットに任せてしまう際には、このことを念頭に置く価値がある。
この研究は実世界でのコストを測定していないが、リスクの輪郭は想像しやすい。もし実際のチャットボット利用において同様の誤りが十分な頻度で起きれば、結局は重要でなかった所見をめぐる不要な追跡検査、生検、そして患者の不安の積み重ねにつながりかねない。ただしそれはあくまで仮説であり、今回のベンチマークが実証したものではない。
「多肢選択式テスト」の限界
Choosing Wiselyのシナリオは、設計上、きれいな多肢選択式テストに近い――定評あるガイドライン機関による「正解」が確立された、明確な臨床状況である。しかし実際の医療判断の大半はもっと複雑で、患者の不安、家族歴、保険適用、そして短いテキストプロンプトでは捉えきれない無数の詳細によって形作られる。研究の著者ら自身は、5.4%という過剰使用率を「安心材料ではあるが、不完全」と位置づけている――今日の主要なAIモデルが「理由なく検査しない」という広範な原則をある程度吸収していることを示す強い証拠である一方、集団自体の判断が割れている場面では、モデルも欠点を含めて依然として「多数派の判断」をデフォルトにしてしまうという警告でもある。
現時点での実践的な教訓は、「AIチャットボットは医療相談全般に安全かどうか」という話よりも、「その盲点がどこにあるか」という話に近い。このベンチマークでは、モデルが本当に必要なケアを見送ることはまれだった一方、一握りのグレーゾーンのシナリオでは不要な検査が現実の問題として残った。この研究は仮想の症例を用いたものであり、実際の患者ではないため、こうしたパターンが実際の診察室でどう現れるかを明らかにするにはさらなる研究が必要である――だからこそ、境界線上の検査についてのチャットボットの回答は、最終的な答えとして扱うのではなく、実際の医師に相談する際の材料として受け止めるべきだろう。
Xsciens編集部の読み解き
この研究から持ち帰りたいのは「AIは信頼できる/できない」という二択ではなく、「どの場面で頼ってよく、どの場面で医師に確認すべきか」という地図です。
- 5.4%という平均に安心しすぎない。全体の過剰推奨率は低い一方、甲状腺結節の超音波検査では42.8%、低リスク成人の心電図スクリーニングでは28.3%と、特定の場面に誤りが集中しています。平均値だけを見ると、この偏りが見えなくなります。
- 2つのエラー率は母集団が違う。過剰推奨率は「控えるのが正解」の回答、誤った抑制(0.6%)は「対応が必要」の回答から算出されています。2つの数字を同じ土俵で比べることはできません。
- AIの揺らぎは医学界の揺らぎと重なる。誤りが目立った場面は、専門家の間でも線引きが分かれる領域でした。AIの回答がぶれるときは、医学的な合意そのものが固まっていない可能性があると読めます。ただし、この研究は仮想シナリオが対象で、実際の診察での効果やコストは検証されていません。
この読み解きの参考: 原論文(Annals of Internal Medicine, DOI)、Newswise プレスリリース
出典: American College of Physicians / Newswise プレスリリース、AuntMinnie、Annals of Internal Medicine(DOI)
コメントを残す